
ケース面接
2026/11/03
技術設計面接の解説と模範解答|チャットbot開発
目次
技術設計面接(システムデザイン面接)のお題「チャットbot開発」を題材に、事前に押さえておく知識、面接で引き出せる前提、論点、模範解答、よくあるつまずきを順に解説します。
ほかのお題の解説は技術設計面接の解説と模範解答まとめにあります。
より詳しい情報はこちら
この記事で使う設計の基礎は、日本語のシステムデザイン面接の教材 SystemDesign InterviewCat で詳しく学べます。この記事の各節に関係する章は次のとおりです。
InterviewCat の章 | この記事で関係する節 |
|---|---|
SystemDesign InterviewCat の全体像 | |
面接で見られることと進め方 | |
事前知識、5. 検索の設計 | |
4. 全体構成(回答を少しずつ流す) | |
4. 全体構成(取り込みワーカー) | |
4. 全体構成(原本の PDF の置き場) | |
8. 障害への備え(LLM のトークン上限とピーク) | |
8. 障害への備え(LLM API と顧客 DB が止まったとき) |
事前知識:RAG の検索方式と最初の仮説
設計面接では、お題を聞いた時点で「たぶんこの作りだろう」という仮説を持ち、前提を聞くたびにそれを確かめたり崩したりします。文書を根拠に答えるチャットbotのお題なら、まず「質問に合う文書の箇所をどうやって探すか」の選択肢を押さえておきます。この探し方を検索方式と呼びます。
質問に答えるまでの流れ
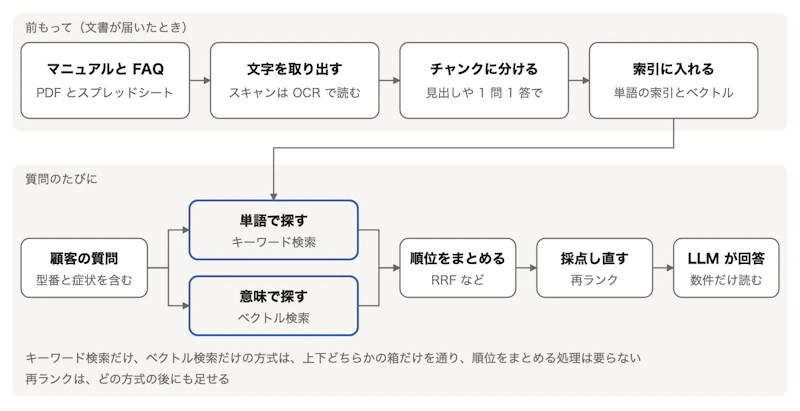
文書を根拠に答える仕組みは、文書が届いたときに前もって行う準備と、質問のたびに行う処理の 2 つに分かれます。検索方式は、準備で何を索引に入れ、質問のときにどう探すかの組み合わせです。下の図の「単語で探す」と「意味で探す」のどちらを通るか、その後に何を足すかで方式が分かれます。
- RAG:質問に合う文書の箇所を検索し、それを LLM に渡して、その範囲だけを根拠に答えさせる作り方
- チャンク:文書を検索しやすい大きさに分けた 1 片。マニュアルなら節や表、FAQ なら 1 問 1 答が単位の候補になる
- 埋め込み:文章を、意味の近さを測れる数値の並び(ベクトル)に変えること。言い回しが違っても意味が近い文章は近いベクトルになる
- 索引:検索を速くするために前もって作っておく表。単語からチャンクを探す表と、埋め込みのベクトルが近いチャンクを探す表がある
それぞれの方式で何が起きるか
顧客が「NR-F516 の製氷皿に氷ができない」と聞き、マニュアルには同じ症状が「製氷しない」と書かれているとします(型番は説明のための架空のものです)。この 1 つの質問で、方式ごとに裏で起きることを並べます。
キーワード検索:質問を単語に分け(日本語は辞書で区切ります)、同じ単語を多く含むチャンクほど点数を高くします。型番やエラーコードのように、文字がそのまま一致すべき語に強い方式で、質問の NR-F516 は同じ型番を書いたチャンクに当たります。弱いところは、言い換えに弱いことです。顧客は「氷ができない」と書き、マニュアルは「製氷しない」と書いているので、同じ内容でも拾えないことがあります。
ベクトル検索:質問とチャンクをそれぞれ埋め込み、ベクトルが近いチャンクを上位にします。キーワード検索と比べると、「氷ができない」と「製氷しない」のような言い換えでも、意味の近い節を拾えます。多言語に対応した埋め込みなら、英語の質問で日本語の文書を拾うこともできます。弱いところは、文字の完全一致を保証しないことです。NR-F516 と NR-F517 はベクトルではほぼ同じ位置に来るので、1 文字違いで仕様が違う型番のチャンクが混ざるおそれがあります。
ハイブリッド検索:キーワード検索とベクトル検索を並べて実行し、2 つの順位を 1 つにまとめます(RRF という方法がよく使われます)。この例では、NR-F516 が一致するチャンクと「製氷しない」の節の両方を上位に集められるので、製品のサポート文書では出発点になりやすい方式です。弱いところは、索引を 2 種類保つ手間が増えることです。また、まとめた点数は順位だけで決まるので、どの質問でも 1 位の点数はほぼ同じになり、「良い根拠が見つからなかった」ことの判定には使えません。
再ランク:検索で拾ったあとに足す処理で、上のどの方式とも組み合わせられます。検索で数十件拾い、質問とチャンクの組を 1 件ずつ読み比べて、どれだけ合っているかを点数にし直し、上位の数件だけを LLM に渡します。この例なら、NR-F516 の「製氷しない」の節は高い点数になり、同じ冊の「製氷皿の洗い方」の節は低くなります。検索だけの場合と比べて上位の精度が上がり、LLM に渡す量も減ります。点数を付け直す時間がかかるので、最初の文字が出るまでの時間に足されます。再ランクの点数は質問とチャンクの合い方そのものを表すので、ハイブリッド検索のまとめた点数と違い、「答えられる根拠があるか」の判定に使えます。
どの方式でも、チャンクの単位を決めるのは別の判断です。固定の文字数で区切るのが一番簡単ですが、手順や表が途中で切れます。見出しで区切れば 1 つの話題が 1 つのチャンクに収まり、そのチャンクがマニュアルの何ページにあるかも記録できます。
方式を比べる
方式の違いは、型番を含む質問と言い換えた質問の 2 つの場面に、「答えられる根拠が無いことを点数で判定できるか」を加えて比べると分かりやすくなります。ここでも「NR-F516 の製氷皿に氷ができない」で比べます。
方式 | 型番 NR-F516 を含む質問で | 「氷ができない」と言い換えた質問で | 根拠が無いことを点数で判定できるか |
|---|---|---|---|
キーワード検索 | NR-F516 を書いたチャンクを拾える | マニュアルの「製氷しない」の節を拾えないことがある | 難しい。点数に上限が無く、質問の長さで変わる |
ベクトル検索 | NR-F517 など似た型番のチャンクが混ざる | 意味の近い「製氷しない」の節を拾える | ある程度できる。近さの値に足切りの点数(閾値)を置ける |
ハイブリッド検索 | NR-F516 を書いたチャンクが上位に来やすい | 「製氷しない」の節も拾える | できない。まとめた点数は順位だけで決まるため |
ハイブリッド検索 + 再ランク | NR-F516 を書いたチャンクが上位に来やすい | 「製氷しない」の節も拾える | できる。再ランクの点数に閾値を置ける |
表から分かるとおり、型番と言い換えの両方に強いのはハイブリッド検索で、根拠が無いことを判定するには再ランクの点数が要ります。一方で、どの方式も NR-F517 のような似た型番が混ざることを完全には防げません。1 文字違いの型番を取り違えないためには、検索の点数とは別に、型番で絞り込む仕組みが要ります。
最初の仮説
お題文だけを読んだ段階では、次の仮説を置きがちです。どれも筋は悪くありませんが、前提を聞くと一部が崩れます。答え合わせは「隠れていた前提を見直す」で行います。
仮説 | 中身 | 確かめること |
|---|---|---|
1 | FAQ とマニュアルを固定の文字数で区切って埋め込み、ベクトル検索すれば答えられる | 型番の数と似かた、文書の形(表、スキャン)、引用の求め方 |
2 | LLM に「分からなければ答えないで」とプロンプトで指示すれば、誤回答は防げる | 誤回答の重さ、答えてはいけない質問があるか |
3 | 答えられない質問は、いつでも有人チャットへ回せばよい | オペレーターの人数と時間帯、有人へ回る件数の目標 |
4 | 文書は最初に一度入れれば、あとはときどき入れ直せばよい | 更新の頻度と届き方、文書どうしの食い違い、直す人の数 |
お題と要件
面接官から示されるお題は次のとおりです。
本日はシステムの設計方法についてディスカッションしたいと思います。今、家電メーカーのWebサイトで、問い合わせ対応を楽にするためのチャットbotを作ることを考えています。顧客がチャットで質問すると、FAQと製品マニュアルを根拠に回答し、答えられない質問は有人チャットに引き継ぐようにしたいです
▼このお題は CaseMatch の AI 面接で、面接官に前提を質問しながら練習できます。
前提は質問すれば答えてもらえます。面接で引き出せる前提を、検索方式の選び方に関わるものとそれ以外に分けて並べます。種類の列は、機能要件、非機能要件、制約、将来の要望のどれにあたるかです。値の列は、面接官が答える文をそのまま載せています。設計への影響の列は、次の節の問いを考えてから読んでください。
検索方式の選び方に関わる前提
事前知識の比較表の 3 つの比べ方(型番を含む質問、言い換えた質問、根拠が無いことの判定)と、チャンクの単位、索引の入れ替え方を決める前提です。
種類 | 前提 | 値 | 設計への影響 |
|---|---|---|---|
非機能 | 誤回答 | 根拠を示せない質問には答えず有人チャットへ回す。答えられる割合より、誤回答の少なさを優先する | 根拠が無いことを点数で判定する |
制約 | 引用 | 法務の要望で、回答には根拠になったマニュアルの該当ページを示す | チャンクにページ番号を持たせる |
機能 | マニュアル | マニュアル約800冊、毎週どこかが更新される | 索引の入れ替えを毎週回す |
制約 | マニュアルの形 | マニュアルはPDFで平均120ページ、表と図が多く、約1割は文字情報のないスキャンPDF | OCR と表の取り出しが要る |
制約 | 更新の届き方 | 更新はPDFの差し替えで届き、どこが変わったかの情報は付かない | 差分ではなく冊ごとに入れ替える |
機能 | FAQ | FAQは約3,000件、CSチームがスプレッドシートで管理している | 1 問 1 答を 1 チャンクにする |
非機能 | 型番 | 型番は約1.5万種類、1文字違いで仕様が異なる型番が多い | ベクトル検索だけでは取り違える |
将来 | 多言語 | 問い合わせの約3%が英語・中国語、いずれ多言語に対応したい | キーワード検索と安全の判定の語の一覧が日本語だけになる |
それ以外の前提
範囲、規模、応答の速さ、有人対応、つなぐ先、体制、文書の扱いのように、どの検索方式を選んでも別に設計が要る前提です。
種類 | 前提 | 値 | 設計への影響 |
|---|---|---|---|
機能 | 目標 | 有人チャットへ回る件数を、1年で月3万件から1.5万件に減らしたい | 答えない判断を厳しくしすぎると届かない |
機能 | 対象外 | 購入前の製品比較や、在庫・価格の質問は対象外 | 対象外の質問を見分けて案内する |
非機能 | 件数 | 問い合わせは月約12万件、うち有人チャットへ回るのは現状約3万件 | 1 件あたりの費用の上限が決まる |
非機能 | 同時会話 | 平常時の同時会話は約80、新製品の発売日とリコール発表の当日にピーク500 | LLM のトークン上限はピークで決まる |
非機能 | ピーク | ピーク同時500会話 | 受けきれない分を待たせる仕組みが要る |
制約 | オペレーター | 有人チャットのオペレーターは最大60席、平日9〜18時のみ | 夜間と休日は有人へ回せない |
非機能 | 応答の速さ | 最初の文字が3秒以内に出始める | 回答を少しずつ流し、生成の前の処理を短くする |
機能 | 有人チャット | 有人チャットは既存のSaaSで、APIから会話を引き継げ、履歴も渡せる | 引き継ぎは SaaS の API に任せる |
機能 | 修理受付 | 修理受付には保証情報の確認と顧客DB連携が必要 | 修理受付は検索とは別の流れにする |
制約 | 顧客DB | 顧客DBは社内のオンプレミスにあり、照会APIは毎晩1〜5時にメンテナンスで止まる | 夜間は受け付けだけして後で照会する |
制約 | LLM | 使ってよいLLMは社内承認済みのクラウドAPI 1社のみ、1分あたりのトークン数に上限がある | 上限を超えても別の LLM へは切り替えられない |
制約 | 安全 | 発火・感電など安全に関わる質問には回答しない | 生成の前で止める |
制約 | 製品事故 | 安全に関わる誤回答は製品事故の報告対象になりうる | 止めたことと理由を記録に残す |
制約 | 個人情報 | 顧客が氏名や電話番号を入力することがあり、会話ログの保存は90日まで | 改善に使う質問は個人情報を除いて別に持つ |
非機能 | bot の停止 | bot停止中も有人チャットは使える | 有人チャットを bot に依存させない |
制約 | 体制 | 回答を直す担当はCSの3名、開発と運用を担うエンジニアは2名 | 直す対象を件数の多い順に絞って渡す |
機能 | 要約 | オペレーターは引き継ぎ時に、それまでの会話の要約を見たい | 引き継ぐときに要約を作って渡す |
制約 | 費用 | LLMと検索の費用は月100万円以内 | LLM に渡すチャンクの数を絞る |
機能 | 古い製品 | 生産終了から10年以上たつ製品の問い合わせが全体の約2割 | 古いマニュアルも索引から外さない |
制約 | 文書の食い違い | FAQとマニュアルの記載に食い違いがある | どちらを正とするかを決める |
制約 | 期間 | 3か月後に、冷蔵庫・洗濯機など主要5カテゴリからリリースする | 最初は 5 カテゴリのマニュアルだけを入れる |
隠れていた前提を見直す
お題文は「FAQ とマニュアルを根拠に答え、答えられない質問は有人へ」としか言っていません。前提の表は、質問して初めて出てきたものです。設計への影響を見る前に、あらためて前提を読み直し、お題文の裏に何が隠れていたかを考えます。先に次の問いを考えてから、前提の表の「設計への影響」の列と見比べてください。
- 前提のうち、互いにぶつかっている 2 つの組を 3 組挙げてください。
- 有人へ回す件数を増やしたい理由と、減らしたい理由を、前提から 1 つずつ挙げてください。
- 最初の仮説 1〜4 のうち、どれがどの前提で崩れますか。
- お題文からは読み取れなかったのに、設計を一番大きく変えた前提はどれですか。
前提どうしのぶつかり
前提の多くは単独では難しくありません。難しいのは 2 つが互いに逆を向いているところで、このお題では次の 3 組です。これがそのまま、面接の後半で詳しく問われる 3 つの論点(深掘り)になります。
ぶつかる前提 | なぜぶつかるか | 解き方 |
|---|---|---|
型番は 1 文字違いで仕様が違う × 顧客は症状を言い換えて書く | 言い換えを拾うにはベクトル検索が要るが、ベクトル検索は似た型番を取り違える | ハイブリッド検索で拾い、型番は質問から取り出して完全一致で絞る |
誤回答の少なさを優先、安全に関わる質問は答えない × 有人へ回る件数を半分に、オペレーターは平日 9〜18 時のみ | 答えない判断を厳しくするほど有人が増え、夜間や休日は回す先が無い | 止める条件を判定ごとに具体的に決め、回す前に聞き返しで救える質問を救う。時間外は受け付けて折り返す |
FAQ とマニュアルが食い違い、毎週更新される × 直す担当は CS の 3 名 | どこが間違っているかを全部の会話から探す人手は無い | 失敗した会話だけを原因別に束ね、件数の多い順に CS へ渡す |
仮説の答え合わせ
仮説 | 崩した前提 | 置き換え |
|---|---|---|
1. 固定の文字数で区切ってベクトル検索 | 型番 1.5 万種類、表とスキャン PDF、該当ページの引用 | チャンクは見出しと表の単位で切ってページ番号を持たせ、ハイブリッド検索に型番の絞り込みを足す |
2. プロンプトで答えないよう指示 | 安全に関わる質問、製品事故の報告対象 | プロンプトだけに頼らず、生成の前に安全の判定と根拠の有無の判定を置き、生成しながら 1 文ずつ引用を確かめる |
3. いつでも有人へ回す | 60 席で平日 9〜18 時のみ、有人を半分に減らす目標 | 回す前に型番の聞き返しで救い、時間外は受付票を作って翌営業日に折り返す |
4. 文書は最初に一度入れる | 毎週の差し替え、差分の情報なし、FAQ との食い違い | PDF のハッシュで変わった冊を見つけて冊ごとに入れ替え、失敗した会話から直す流れを常に回す |
このお題は、文書をベクトル DB に入れて LLM に答えさせるだけの RAG に見えます。しかし実際に問われるのは、1 文字違いの型番と安全に関わる質問を抱えたまま、答えない判断と有人への引き継ぎを、オペレーターの人数と時間帯に合わせて組み立てる設計です。
解説:このお題の論点
論点は 3 つあり、重さの順に検索の設計、答えない判断と有人への引き継ぎ、回答を直していく仕組みです。どれも前提のうち 2 つが互いにぶつかっており、どちらをどう守るかを自分で決めて説明できるかが問われます。チャットの画面の作りは深入りしなくてかまいません。
模範解答の深掘り(5〜7)では、論点ごとに「弱い答え」「よい答え」「より良い答え」を並べ、何が足りないかを示しています。
模範解答
面接での問答の順には合わせず、このお題への答えを 1 つの設計としてまとめた解答例です。設計の筋は、マニュアルを見出しと表の単位でページ番号つきのチャンクにし、ハイブリッド検索と型番の絞り込みで探し、生成の前と途中に止める判定を置いて、止めたものは要約つきで有人へ渡す、というものです。前提に無いことを仮定として置いたところは、その旨を書いています。
1. 作る範囲
前提を確かめたうえで、最初に作る範囲を次のように切ります。
- 作る:マニュアルと FAQ の取り込みと索引、検索と回答の生成、該当ページの引用、安全に関わる質問と根拠の無い質問の判定、有人チャットへの引き継ぎと要約、時間外の受付、失敗した会話を集めて CS に渡す仕組み
- 作らない:購入前の製品比較、在庫と価格の案内、修理受付の手続きそのもの(受付の案内までは作る)、多言語対応、チャットの画面の作り込み
設計の要は、回答の生成の前に止める判定を置くことです。安全に関わる質問と根拠の無い質問は LLM に生成させる前に止め、生成した文は 1 文ずつ引用を確かめてから出します。
2. 見積もり
見積もりで出すのは、構成を決める 3 つの数字だけです。どれも前提の値から計算できます。
見積もり | 計算 | 決まること |
|---|---|---|
検索する文書の量 | 800 冊 × 平均 120 ページ = 約 9.6 万ページ。うち約 1 割の約 1 万ページはスキャン | 重いのは検索ではなく取り込み(OCR と表の取り出し)。毎週は変わった冊だけを処理する |
1 件あたりの費用 | 月 100 万円 ÷ 月約 12 万件 = 1 件あたり約 8 円 | LLM に渡すのは再ランク後の上位数件に限り、安全の判定は軽い処理で済ませる |
ピークに有人で受けられる割合 | 60 席 ÷ 同時 500 会話 = 約 12% | リコール当日の質問の大半は bot で答え切る必要があり、対象型番の確認までを bot で済ませる(6 の深掘り) |
有人へ回る件数の目標は、月約 12 万件のうち 3 万件(25%)を 1.5 万件(12.5%)に下げることです。答えない判断を厳しくしすぎるとこの目標に届かないので、回した理由を記録し、内訳を見ながら直します(7 の深掘り)。
3. データモデル
索引のチャンクはどれも、どの文書のどの版の何ページから来たかを持ちます。版ごとに入れ替えるので、引用したページが古い版を指すことはありません。中心になる表は次の 4 つです。
表 | 主な項目 | 書き換え |
|---|---|---|
文書 | 文書 ID、種類(マニュアル、FAQ)、対象の型番の一覧、公開中の版、PDF のハッシュ | 差し替えのたびに公開中の版だけを付け替える |
チャンク | チャンク ID、文書 ID と版、ページ番号、見出しの並び、本文、埋め込み、型番 | しない。版ごとに作り、古い版はまとめて消す |
会話 | 会話 ID、状態(bot、有人、受付票)、引き継いだ理由、要約、作成日時 | 状態だけを進める。90 日で消す |
回答の記録 | 会話 ID、質問、使ったチャンク ID、再ランクの点数、止めた判定と理由、顧客の評価 | 追記のみ。90 日で消す |
回答の記録には、どのチャンクを使い、どの判定でなぜ止めたかを残します。製品事故の報告が求められたときの説明と、7 の原因の切り分けの両方に、この記録を使います。
4. 全体構成
文書の取り込みは裏で非同期に動き、会話のときは検索と生成だけを同期で行います。有人チャットは既存の SaaS のままにし、bot はそこへ会話を渡す側に立ちます。
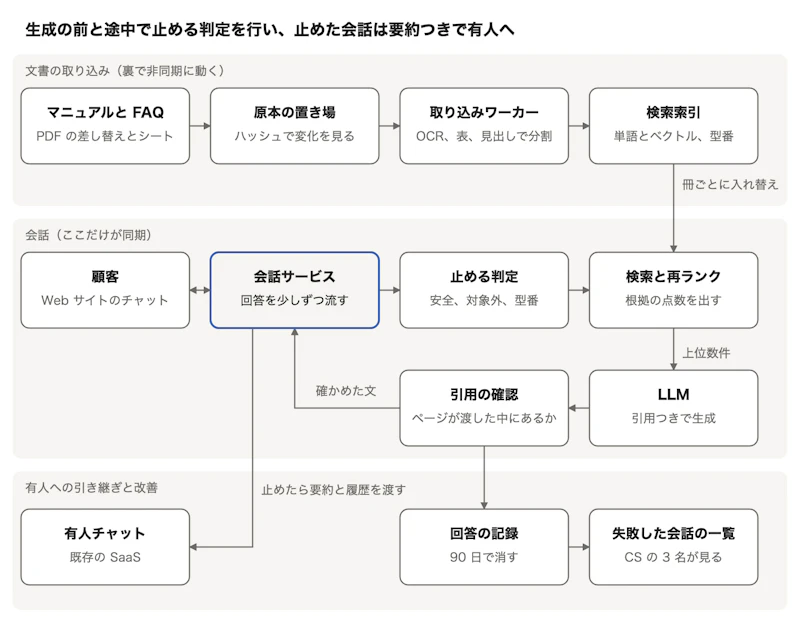
色を付けた会話サービスがこの設計の要で、どの判定で止めるか、止めたら誰に何を渡すかをここで決めます。
- 原本の置き場と取り込みワーカー:差し替えられた PDF をオブジェクトストレージに保存し、ハッシュが前の版と違う冊だけを取り込みのキューに積みます。ワーカーは OCR とレイアウトの解析で本文、見出し、表、ページ番号を取り出し、チャンクに分けて埋め込みます。FAQ はスプレッドシートから 1 問 1 答ずつ取り込みます。
- 検索索引:同じチャンクを、単語の索引とベクトルの索引の両方に入れ、型番の欄で絞り込めるようにします。1 冊分のチャンクをすべて入れ終えてから公開中の版を付け替えるので、取り込みの途中で半端な版が検索されることはありません。
- 会話サービス:顧客の質問を受け、止める判定、検索と再ランク、生成、引用の確認の順に呼びます。回答は引用を確かめた文から SSE(サーバーからブラウザへ一方向に流す HTTP の仕組み)で少しずつ返し、最初の文字を 3 秒以内に出します。
- 止める判定:安全に関わる質問、対象外の質問(製品比較、在庫、価格)、型番が分からない質問を、生成の前に見分けます(6 の深掘り)。
- 検索と再ランク、LLM、引用の確認:ハイブリッド検索で拾い、再ランクで上位数件に絞って LLM に渡します。再ランクの点数が閾値を下回れば生成せずに止めます。LLM には渡したチャンクの番号を文ごとに引用させ、引用が渡した範囲にあるかを 1 文ずつ確かめてから流します(6 の深掘り)。
- 有人チャットへの引き継ぎ:止めた会話は、要約と履歴をつけて SaaS の API で渡します。時間外は受付票を作り、翌営業日に折り返します。
- 回答の記録と失敗した会話の一覧:使ったチャンク、点数、止めた理由、顧客の評価を残し、失敗した会話を原因別に束ねて CS に渡します(7 の深掘り)。
有人チャットの窓口は bot を通らずに開けるようにしておき、bot が止まっても顧客は有人チャットを使えるようにします。修理受付は、保証の確認に顧客 DB が要るので、検索とは別の手続きの流れにし、会話サービスからは修理受付の案内だけを出します。
実例:LinkedIn はカスタマーサービスの質問応答で、過去の問い合わせチケットをただの文章として区切るのをやめ、チケットの構造と関係を保ったまま索引にしました。社内で半年使った結果、1 件の解決にかかる時間の中央値が 28.6% 短くなったと報告しています(LinkedIn, 2024)。文書の区切り方が検索の質を左右する例です。
検索索引には、ハイブリッド検索と再ランクを持つマネージドな検索サービスを使います。エンジニア 2 名で 3 か月という条件では、自分で作るのは型番の絞り込み、止める判定、引用の確認、有人への引き継ぎに絞ります。
代わりの案:検索エンジンを自分で運用し、単語の索引とベクトルの索引を 1 つの DB に持つ構成もあります。分かち書きの辞書に型番を足すなど、検索の細かい調整は自由になります。その代わり、索引の運用と再ランクのモデルの用意が 2 名の仕事に加わるので、最初のリリースでは選びません。止める判定と引き継ぎの設計は、どちらを選んでも変わりません。
5. 深掘り:検索の設計
マニュアルは見出しと表の単位でページ番号つきのチャンクにし、FAQ は 1 問 1 答を 1 チャンクにします。探すときはハイブリッド検索で拾い、型番は質問から取り出して完全一致で絞ります。最初の仮説の 1 は、ここで崩れます。
答えの段階 | 答え | 足りないところ |
|---|---|---|
弱い答え | RAG にしてベクトル DB に入れます | 何をどの単位で入れるかが無い |
よい答え | チャンクに分けて埋め込み、近いチャンクを LLM に渡します | 分割の単位が決まっておらず、似た型番の取り違えと該当ページの引用に答えていない |
より良い答え | 見出しと表の単位で分けてページ番号を持たせ、ハイブリッド検索に型番の絞り込みを足します | なし(中身は下の 6 つ) |
より良い答えの中身は次のとおりです。
- マニュアルは見出しの単位で分ける:1 つの節を 1 チャンクにし、長い節はページの切れ目で分けます。手順の途中で切れず、引用するページ番号もチャンクごとに 1 つか 2 つに決まります。固定の文字数で区切ると、1 つの手順が 2 つのチャンクに分かれ、どちらも単独では答えになりません。
- チャンクの先頭に文脈を足す:本文の前に、製品名、型番、章と節の見出しを書き足してから索引に入れます。「お手入れ」のような節は、どの製品の話かが本文に書かれていないことが多いからです。
- 表は表のまま 1 チャンクにする:仕様表やエラーコードの表は、レイアウトの解析で行と列を保ったまま Markdown の表にし、表の見出しを付けて 1 チャンクにします。文字だけを流し込むと、どの値がどの型番のものかが分からなくなります。スキャン PDF も同じ解析で読み、OCR の確からしさが低いページは索引に入れずに CS の確認待ちにします。
- FAQ は 1 問 1 答を 1 チャンクにする:FAQ の質問文は顧客の言い回しに近いので、質問に合う製品と話題を見つけるのに使います。回答と引用は、同じ型番のマニュアルのページを根拠に作ります。法務の要望で、示すのはマニュアルの該当ページだからです。
- 型番は検索の点数とは別に絞る:質問から型番の形をした文字列を取り出し、型番の一覧と完全一致で照らします。一致すれば、その型番を対象にした文書だけに絞って検索します。一致しなければ、近い型番の候補を示して顧客に選んでもらいます。型番が無い質問は、「本体の側面のラベルに書かれた型番を教えてください」と聞き返します。
- 古い製品のマニュアルも残す:問い合わせの約 2 割は生産終了から 10 年以上の製品なので、生産終了でも索引から外しません。型番で絞るので、新しい製品の文書と混ざることもありません。
文書の更新は、PDF のハッシュで変わった冊を見つけ、冊ごとに入れ替えます。どこが変わったかの情報は付かないので、ページの差分を取ろうとせず、1 冊分を作り直して公開中の版を付け替えます。1 冊は平均 120 ページなので、毎週変わる冊だけを作り直す量は見積もりの全体(約 9.6 万ページ)よりずっと小さく済みます。
FAQ とマニュアルの食い違いは、マニュアルを正とします(ここは仮定で、面接では確かめたい点として述べます)。検索の結果に同じ型番の FAQ とマニュアルが両方入り、内容が食い違っていれば、マニュアルの方を根拠に答え、その FAQ を CS の確認の一覧に送ります。
実例:Anthropic は、チャンクに文書内での位置づけを説明する文を足してから、埋め込みとキーワード検索の両方の索引に入れる方法を試し、上位 20 件に答えが入らない割合を 5.7% から 2.9% に下げました。再ランクを足すと 1.9% まで下がっています。同じ記事は、エラーコードのような固有の文字列にはキーワード検索の完全一致が向くと述べています(Anthropic, 2024)。チャンクの先頭に文脈を足す工夫は、この設計の「製品名と型番を書き足す」と同じ考え方です。
実例:Uber は社内規程の PDF で、表がページをまたいで崩れる問題に当たりました。表を Markdown に直し、チャンクに要約やキーワードを足し、キーワード検索とベクトル検索を組み合わせて、誤った案内を 60% 減らしています(Uber, 2025)。表の多いマニュアルを表のまま 1 チャンクにする理由になります。
6. 深掘り:答えない判断と有人への引き継ぎ
答えない判断は、プロンプトの指示ではなく、生成の前と生成の途中に置いた判定で行います。止めた会話は、要約と履歴をつけて有人へ渡します。
答えの段階 | 答え | 足りないところ |
|---|---|---|
弱い答え | プロンプトで「分からないことは答えない」と指示し、答えられなければ有人に回します | 何を見て回すかが無く、安全に関わる質問を LLM が答えてしまう余地が残る |
よい答え | 再ランクの点数が閾値を下回ったら、生成せずに有人へ回します | 安全に関わる質問は根拠が見つかっても答えてはいけない。夜間と休日の回し先も無い |
より良い答え | 生成の前に安全と根拠の有無で止め、生成した文は 1 文ずつ引用を確かめてから流し、止めた会話は要約つきで渡します | なし(中身は下の流れ) |
- 安全の判定(生成の前):発火、煙、焦げ臭い、感電、漏電などに触れる質問を見つけます。まず語の一覧で広く拾い、そのうえで LLM に分類させて「感電しないように掃除したい」のような安全な質問を通します。止めた質問には、法務と決めた定型の文面(使用をやめて電源プラグを抜く、窓口の連絡先)だけを出し、有人へ回します。このとき検索も生成もしません。
- 対象外と型番の判定(生成の前):製品比較、在庫、価格の質問は、定型の文面で売り場や販売店の案内を出します。型番が分からない質問は聞き返します。聞き返しで救える質問を有人に回さないことが、有人を半分に減らす目標に直接つながります。
- 根拠の有無の判定(生成の前):再ランクの点数が閾値を下回れば、生成せずに有人へ回します。閾値は、誤回答を減らす方へ寄せて置き、回した件数の内訳を見て調整します。
- 引用の確認(生成の途中):LLM には、渡したチャンクの番号を文ごとに引用させます。出力は 1 文ずつ受け取り、その文の引用が渡したチャンクの中にあると確かめてから顧客に流します。引用の無い文や、渡していない番号を引用した文が出たら、そこで生成を止めて有人へ回し、確かめていない文は画面に出しません。最初の 1 文は短いので、確かめる時間を足しても最初の文字は 3 秒以内に出せます。安全に関わる質問は 1 で止まっているので、ここで止めるのは根拠の弱い回答だけです。
有人へ渡すときは、SaaS の API で会話の履歴を渡し、オペレーターが最初に見る欄に要約を載せます。要約は、型番、症状、bot が案内したこと、顧客が試したこと、bot が止めた判定と理由の 5 つの項目で LLM に作らせます。オペレーターは、聞き直さずに続きから対応できます。
時間外(平日 9〜18 時の外)は、有人へ回す先がありません。この間に止めた会話は、要約と連絡先を受付票として残し、翌営業日にオペレーターから折り返します。リコール発表の当日は、同時会話がピークの 500 になり、60 席では受けきれません。リコールに関する質問は、CS が当日に追加する FAQ と対象型番の一覧で bot が答え、対象かどうかの確認までを bot で済ませます。
安全に関わる誤回答は製品事故の報告対象になりうるので、止めた質問、止めた判定、出した文面を回答の記録に残します。安全の判定で止めすぎた件数も、同じ記録から数えられます。
実例:Anthropic の文書は、誤回答を減らす方法として、分からないと言うことを明示的に許す、回答の主張ごとに文書からの引用を付けさせる、裏づけの引用が見つからない主張は取り消させる、を挙げています(Claude Docs)。同じ文書は、これらで誤りが無くなるわけではないとも書いており、この設計で安全に関わる質問をプロンプトに任せず生成の前で止める理由になります。
7. 深掘り:回答を直していく仕組み
失敗した会話だけを集め、原因が文書、検索、生成のどれかを分けて、件数の多い順に CS の 3 名へ渡します。
答えの段階 | 答え | 足りないところ |
|---|---|---|
弱い答え | 会話のログを取っておきます | 月約 12 万件のログを誰がどう読むかが無い |
よい答え | 低評価と有人に回った会話を集め、CS が FAQ や文書を直します | 原因が文書に無いのか、検索で外したのかが分からず、直した結果が正しいかを確かめられない |
より良い答え | 失敗した会話を原因別に分けて束ね、直したら同じ質問で確かめます | なし(中身は下の 4 つ) |
- 集める会話:顧客が低評価を付けた会話、有人に回った会話、根拠が無くて止めた会話、聞き返しのあと顧客が離れた会話を集めます。どれも回答の記録から機械的に選べます。
- 原因を分ける:有人に回った会話では、オペレーターが答えに使ったマニュアルのページを記録してもらいます。そのページが索引に無ければ「文書に無い」、索引にあるのに検索の上位に入っていなければ「検索で外した」、上位に入って LLM に渡したのに回答が誤っていれば「生成の誤り」と分けられます。直す人も分かれます。文書に無いものは CS が FAQ を足し、検索と生成はエンジニアが直します。
- 束ねて渡す:3 名で全部は読めないので、型番のカテゴリと原因で束ね、件数の多い順に並べた一覧を CS に渡します。有人に回った月 3 万件のうち、上位の束から直すほど目標に近づきます。
- 直したら確かめる:直す元になった質問を評価用の質問として残し、FAQ や索引を入れ替える前に同じ質問を流して、正しいページが上位に来るか、回答が変わったかを確かめます。評価用の質問は、氏名と電話番号を取り除いた質問文だけを残し、90 日の保存期限がある会話ログとは分けて持ちます。
実例:Uber の社内向けの質問応答 bot は、Slack 上の回答に「解決した」「役に立った」「役に立たない」「関係ない」のボタンを付け、押された結果を集計しています。さらに、元の文書を LLM に採点させ、文書ごとに直すべき点の提案を作って持ち主に返しています(Uber, 2024)。失敗した回答から文書を直す側へ戻す流れを、仕組みとして持っている例です。
8. 障害への備えと監視
bot のどこが止まっても、顧客は有人チャットの窓口を使えます。bot は答えられないときに誤った答えを出すより、答えずに窓口を案内するほうを選びます。
止まるもの | 顧客に見えること | 手当て |
|---|---|---|
LLM のトークン上限(ピーク) | 新しい会話で「順番にご案内します」と待ちの表示が出る | 会話サービスでトークンの使用量を数え、上限に近づいたら新しい会話をキューで待たせる。上限で断られた呼び出しは、指定された時間を待ってから再試行する |
LLM API | bot が閉じ、有人チャットの窓口だけが出る | 失敗が続いたら呼び出しを一時的に止め(サーキットブレーカー)、再試行で負荷を重ねない |
検索索引 | LLM API が止まったときと同じ | 根拠なしで生成させない。検索が失敗した質問は、根拠が無い質問と同じ扱いにする |
取り込みワーカー | 前の版のマニュアルで答える | 冊ごとに入れ替えるので半端な版は出ない。失敗した冊は再試行し、決めた回数で失敗したら通知する |
顧客 DB(毎晩 1〜5 時) | 修理の申し込みは受け付けたことだけが表示される | 受付票を残し、5 時以降に保証情報を照会して確定する |
有人チャットの SaaS | 引き継げない旨と、折り返しの受付が出る | 受付票を作り、復旧後にオペレーターから折り返す |
監視するのは、有人へ回った割合と止めた判定の内訳、再ランクの点数の分布、最初の文字が出るまでの時間、トークンの使用量と月の費用、低評価の割合です。有人へ回った割合が急に増えたら、取り込みの失敗か、新製品やリコールで索引に無い質問が増えたかを調べます。
9. 条件の変更への対応
面接の後半では、運用で起きた不具合や将来の要望という形で条件が足されます。答え方は、今の設計でなぜ起きたか、何をきっかけに何をどう処理して直すか、変えずに済むところはどこか、の順です。
例 1:マニュアルを差し替えたのに、古い版のページを引用した回答が出ていた
- 原因:新しい版のチャンクは入ったが、古い版のチャンクが索引に残り、同じ型番の新旧が両方検索された。もしくは取り込みが途中で失敗して再実行され、同じ冊のチャンクが二重に入った。
- 直し方:PDF の差し替えをきっかけに、ハッシュが変わった冊を 1 冊ずつ取り込みます。チャンク ID は文書 ID、版、位置から作るので、再実行しても同じ ID になり二重に入りません。1 冊分を入れ終えてから公開中の版を付け替え、検索は公開中の版のチャンクだけを対象にし、そのあと古い版を消します。消すのに失敗しても、公開中の版で絞っているので古い版は検索されません。
- 変えずに済むところ:会話サービス、止める判定、有人への引き継ぎです。
例 2:英語と中国語の質問にも答えたい
- 影響:キーワード検索は、日本語の文書に英語の質問では型番くらいしか当たりません。安全の判定の語の一覧も日本語だけです。
- 直し方:質問の言語を判定し、日本語に訳してから止める判定と検索に通します。回答は質問の言語で生成し、引用は日本語のマニュアルのページのまま示します。有人へ渡す要約は日本語で作ります。
- 変えずに済むところ:取り込み、索引、引用の確認です。会話サービスに、質問を受けた直後と回答を返す前の 2 か所で訳す処理を足すだけで済みます。
まとめ:選んだものと捨てたもの
判断 | 選んだ案 | 捨てた案、代わりの案 | 理由 |
|---|---|---|---|
チャンクの単位 | マニュアルは見出しと表、FAQ は 1 問 1 答。ページ番号を持たせる | 固定の文字数 | 手順と表が切れず、該当ページを引用できる |
検索方式 | ハイブリッド検索、再ランク、型番の完全一致での絞り込み | ベクトル検索だけ | 1 文字違いの型番を取り違えず、言い換えも拾える |
検索の基盤 | マネージドな検索サービス | 代わりの案:検索エンジンを自分で運用する | エンジニア 2 名で 3 か月なので、作るのは止める判定と引き継ぎに絞る |
答えない判断 | 生成の前に安全と根拠の有無で止め、生成した文は 1 文ずつ引用を確かめてから流す | プロンプトの指示だけ | 安全に関わる質問を LLM に答えさせる余地を残さない |
時間外 | 受付票を作って翌営業日に折り返す | 有人へ回す | オペレーターは平日 9〜18 時のみ |
文書の更新 | ハッシュで変わった冊を見つけ、冊ごとに入れ替える | ページの差分を取る、毎週全部を作り直す | 差分の情報は付かず、全部の作り直しは OCR が重い |
改善 | 失敗した会話を原因別に束ねて CS へ渡し、直したら同じ質問で確かめる | ログを全部読む | CS は 3 名で、月約 12 万件は読めない |
よくあるつまずき
つまずき | なぜ弱いか | 抜け出す一手 |
|---|---|---|
面接の最初から「RAG にします」と構成を話し始める | 型番の数、文書の形、誤回答の重さなど、検索を決める条件を取りこぼす | 文書の量と形、更新の届き方、誤回答の扱いを先に聞く |
「ベクトル DB に入れます」で終わる | 何をどの単位で入れるかが無く、引用のページも返せない | チャンクの単位とその理由、持たせる項目まで言う |
ベクトル検索だけで型番を探す | 1 文字違いの型番を取り違え、別の製品の手順を案内する | 型番は質問から取り出して完全一致で絞る |
「分からなければ答えない」とプロンプトに書いて終わる | 何を見て止めるかが無く、安全に関わる質問を答えてしまう余地が残る | 生成の前に止める条件を具体的に言う |
答えられない質問はすべて有人へ回す | 有人を半分に減らす目標に届かず、夜間と休日は回す先が無い | 聞き返しで救える質問を救い、時間外は受付票にする |
有人へ回すとだけ言う | オペレーターが最初から聞き直すことになる | 要約に入れる項目まで言う |
改善は「ログを取る」で終わる | 3 名で月約 12 万件は読めず、何を直すかが決まらない | 失敗した会話だけを原因別に束ねて渡す |
▼解説を読んだら、同じお題を AI 面接官を相手に通しで解いてみましょう。
参照元
技術ブログ、論文、公式ドキュメントです。どれも開いて内容を確かめています。検索サービスや LLM の事業者の文書は、自社製品の説明を兼ねています。
節 | 記事 | 参照した内容 |
|---|---|---|
事前知識、5 | Introducing Contextual Retrieval(Anthropic, 2024) | チャンクに文脈を足す方法、キーワード検索(BM25)と埋め込みの併用、再ランクで検索の失敗が減った割合 |
事前知識 | Hybrid search overview(Microsoft Learn) | キーワード検索とベクトル検索を並べて実行し、製品コードのような完全一致にはキーワード検索が強い |
事前知識 | Hybrid search scoring (RRF)(Microsoft Learn) | RRF は順位から点数を作ってまとめる。キーワード検索(BM25)の点数には上限が無い |
事前知識、5 | Chunk documents(Microsoft Learn) | 固定長、見出しなどの構造、意味のまとまりで分ける方法と、文書の題を各チャンクに足す工夫 |
4, 5 | Document layout analysis(Microsoft Learn) | OCR とレイアウトの解析で本文、表、見出し、ページ番号を取り出し、Markdown でも出力できる |
4 | Retrieval-Augmented Generation with Knowledge Graphs for Customer Service Question Answering(LinkedIn, 2024) | 問い合わせチケットの構造を保って索引にし、解決時間の中央値が 28.6% 短くなった |
4 | SSE はサーバーからブラウザへ HTTP で一方向に流す仕組み | |
5 | Enhanced Agentic-RAG(Uber, 2025) | PDF の表が崩れる問題、表の Markdown 化、キーワード検索(BM25)とベクトル検索の併用で誤った案内が 60% 減った |
6 | Reduce hallucinations(Claude Docs) | 分からないと言うことを許す、主張ごとに引用させる、引用の無い主張を取り消させる |
7 | Genie: Uber's Gen AI On-Call Copilot(Uber, 2024) | 回答の評価ボタンの集計と、LLM による文書の採点と直す点の提案 |
8 | Manage Azure OpenAI quota(Microsoft Learn) | 1 分あたりのトークン数の上限、上限を超えたときの 429 と待ち時間の指定、再試行の方法 |
▼ほかのお題の解説
サカモトエンジニア監修
外資系企業のソフトウェアエンジニア。エンジニアのキャリアや面接について X や note で発信し、テック企業を目指すエンジニア向けの面接対策プラットフォーム InterviewCat を運営しています。

公式アカウント
CaseMatch編集部
CaseMatch編集部は、就活・転職における面接対策やキャリア選択に役立つ情報を発信する編集チームです。AI面接練習サービス「CaseMatch」の運営で得た知見や、企業選考・ケース面接・自己分析に関する実践的なノウハウをもとに、候補者が納得感を持って選考に臨めるコンテンツをお届けします。
面接練習で、選考を有利に進めよう。

1分で完了


