
ケース面接
2026/11/03
技術設計面接の解説と模範解答|社内向けMCP開発
目次
技術設計面接(システムデザイン面接)のお題「社内向けMCP開発」を題材に、事前に押さえておく知識、面接で引き出せる前提、論点、模範解答、よくあるつまずきを順に解説します。
ほかのお題の解説は技術設計面接の解説と模範解答まとめにあります。
より詳しい情報はこちら
この記事で使う設計の基礎は、日本語のシステムデザイン面接の教材 SystemDesign InterviewCat で詳しく学べます。この記事の各節に関係する章は次のとおりです。
InterviewCat の章 | この記事で関係する節 |
|---|---|
SystemDesign InterviewCat の全体像 | |
面接で見られることと進め方 | |
事前知識、5. 誰の身元で呼ぶか | |
4. 全体構成(MCP サーバーを社内データの入口にする) | |
5. 誰の身元で呼ぶか、6. データの取り先 | |
6. データの取り先(BigQuery の使いどころ) | |
7. ツールの粒度とサービスの負荷 | |
7. ツールの粒度とサービスの負荷(返す件数の上限) |
事前知識:誰の身元で各サービスを呼ぶかと最初の仮説
設計面接では、お題を聞いた時点で「たぶんこの作りだろう」という仮説を持ち、前提を聞くたびにそれを確かめたり崩したりします。MCP は、Claude や ChatGPT のような AI のアプリ(この記事では AI クライアントと呼びます)と、外部のデータや機能をつなぐための共通の約束事です。社内データを AI から引き出すお題なら、まず「MCP サーバーが各サービスを誰の身元で呼ぶか」の選択肢を押さえておきます。
管理画面から聞くときと、AI から聞くときの違い
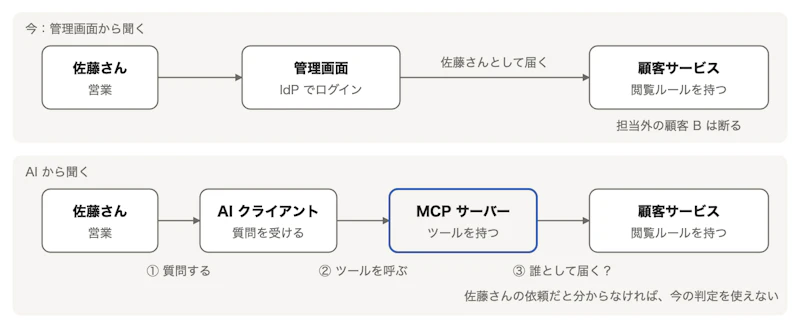
今は、営業の佐藤さんが管理画面で顧客を開くと、顧客サービスには佐藤さんからの依頼として届き、顧客サービスは佐藤さんの担当外の顧客 B を断ります。AI から聞くと、顧客サービスに届くのは MCP サーバーからの呼び出しになり、そのままでは佐藤さんからの依頼だと分かりません。
- MCP サーバー:AI に「顧客を探す」のような関数(ツール)を見せ、呼ばれたら社内のデータを取って返すプログラム
- トークン:「佐藤さんが、この相手に、何時まで使ってよい」と書かれたログインの証明
- IdP:社員のログインを受け持ち、トークンを出す社内の仕組み
- サービスアカウント:人ではなくプログラムに割り当てる ID。今はサービス間の呼び出しをこれで認証している
- 閲覧ルール:誰がどの顧客を見られるかの判定(営業は担当顧客だけ、など)。今は各サービスが自分で持っている
MCP サーバーの置き方は先に決まります。MCP サーバーは、社員の PC の中で動かす方式(ローカル。通信方式は stdio)と、社内のサーバーに 1 つ置いてネットワーク越しにつなぐ方式(リモート。通信方式は Streamable HTTP)があります。PC の中で動かす方式はブラウザの Web 版から使えず、各サービスを呼ぶための資格情報を全員の PC に置くことになるので、社内データの入口には社内に 1 つ置く方式を使います。
それぞれの方式で何が起きるか
MCP サーバーを社内に置いても、各サービスをどう呼ぶかは別に決めます。図の③で佐藤さんとして届くかどうかが、「見せてよい範囲」を誰が判定するかを決めるので、このお題で一番大きい選択です。
共通のサービスアカウントで呼ぶ:MCP サーバーが 1 つのサービスアカウントで全サービスを呼び、佐藤さんに見せてよいかは MCP サーバーの中で絞ります。各サービスはサービス間の呼び出しを今もサービスアカウントで受けているので、各チームの改修はほとんど要りません。弱いところは 2 つです。閲覧ルールが各サービスと MCP サーバーの 2 か所に分かれ、片方だけ変わると、食い違った分だけ佐藤さんに担当外の顧客 B が見えます。また、MCP サーバーの資格情報が漏れると、全サービスの全顧客が見えます。
利用者の身元を添えて呼ぶ(委任):MCP サーバーが「佐藤さんの代わりに呼んでいる」ことを示して各サービスを呼び、各サービスは今の閲覧ルールを佐藤さんで通します。閲覧ルールは各サービスの 1 か所のままです。その代わり、各サービスに、添えられた利用者を受け取って閲覧ルールに渡す処理(以下、受け取る処理)を足す改修が要ります。添え方は次の 2 通りです。
トークン交換:MCP サーバーが IdP に佐藤さんのトークンを渡し、「顧客サービス宛て、MCP サーバー経由の佐藤さん」と書かれた短い期限のトークンに替えてもらって呼びます。IdP がこの機能に対応している必要があります。
署名つきで添える:今のサービスアカウントの認証に、佐藤さんの ID を MCP サーバーの署名つきで添えます。IdP に頼らずに作れますが、トークン交換と比べると、署名に使う秘密が漏れたとき、誰にでもなりすませる点が弱みです。
AI クライアントから受け取った佐藤さんのトークンを、そのまま各サービスへ転送する作りは、MCP の仕様が禁じています(トークンのパススルー)。MCP サーバー宛てのトークンを別の相手に使い回すことになり、どこを通った呼び出しかを各サービスが区別できなくなるためです。
方式を比べる
身元の渡し方の違いは、「佐藤さんが担当外の顧客 B を聞いたとき」「閲覧ルールが変わったとき」「MCP サーバーが乗っ取られたとき」の 3 つの場面に、各チームの改修の量を加えて比べると分かりやすくなります。
方式 | 佐藤さんが担当外の顧客 B を聞いたとき | 閲覧ルールが変わったとき | MCP サーバーが乗っ取られたとき | 各チームの改修 |
|---|---|---|---|---|
共通のサービスアカウント | MCP サーバーの絞り込み次第で、漏れがあれば見える | MCP サーバー側を直すまで食い違う | 全サービスの全顧客が見える | ほぼ無い |
委任(トークン交換) | 顧客サービスが今の閲覧ルールで断る | 各サービスだけ直せばよい | そのとき使っている利用者の範囲が、短い期限のあいだだけ見える | 交換されたトークンを確かめ、利用者を閲覧ルールに渡す処理を足す |
委任(署名つきで添える) | 顧客サービスが今の閲覧ルールで断る | 各サービスだけ直せばよい | どの利用者にもなりすませる | 署名を確かめ、利用者を閲覧ルールに渡す処理を足す |
表から分かるとおり、改修の少ない共通のサービスアカウントは閲覧ルールが 2 か所に分かれ、閲覧ルールを 1 か所に保つ委任は各チームの改修が要ります。どちらの弱みを引き受けるかは、「今の管理画面で見られない人には見せない」の重さと、各チームに頼める改修の量で決まります。
最初の仮説
お題文だけを読んだ段階では、次の仮説を置きがちです。どれも筋は悪くありませんが、前提を聞くと一部が崩れます。答え合わせは「隠れていた前提を見直す」で行います。
仮説 | 中身 | 確かめること |
|---|---|---|
1 | 各社員の PC で動くローカルの MCP サーバー(stdio)を配ればよい | 使う AI クライアントの種類、Web 版を使うか、配布と更新を誰がするか |
2 | MCP サーバーが 1 つのサービスアカウントで全サービスを呼び、MCP サーバーの中で絞ればよい | 閲覧ルールの持ち主、漏れたときの範囲、各チームに頼める改修の量 |
3 | 全部 BigQuery から取れば、各サービスに負荷をかけずに横断できる | データの新しさ、個人情報の有無、閲覧ルールで判定されるか |
4 | AI に SQL を書かせれば、ツールを作り込まずに何でも答えられる | 各サービスの負荷、DB を直接読んでよいか、スキーマの変わり方、出し過ぎ |
お題と要件
面接官から示されるお題は次のとおりです。
本日はシステムの設計方法についてディスカッションしたいと思います。当社のプロダクトはマイクロサービスで運用していて、約10のサービスがそれぞれ自分のDBを持っています。社員がClaudeやChatGPTから、各サービスのデータ(顧客、契約、利用状況など)をまとめて検索・参照できるように、社内向けのMCPサーバを作ることを考えています。当面は読み取りだけです
▼このお題は CaseMatch の AI 面接で、面接官に前提を質問しながら練習できます。
前提は質問すれば答えてもらえます。面接で引き出せる前提を、誰の身元で呼ぶかに関わるものとそれ以外に分けて並べます。種類の列は、機能要件、非機能要件、制約、将来の要望のどれにあたるかです。設計への影響の列は、次の節の問いを考えてから読んでください。
誰の身元で呼ぶかに関わる前提
事前知識の比較表の比べ方(担当外を断れるか、閲覧ルールが 1 か所か、乗っ取られたときの範囲、各チームの改修)を決める前提です。
種類 | 前提 | 値 | 設計への影響 |
|---|---|---|---|
制約 | ログイン | 全社員が社内のIdPでSSOログインしている | IdP を MCP の認可サーバーにできる |
制約 | サービス間の認証 | 各サービスは社内向けのAPIを持つが、作りはサービスごとにばらばら。サービス間の呼び出しはサービスアカウントで認証している | 利用者の身元を受け取る処理は今は無い |
制約 | 閲覧ルール | 社内の管理画面はIdPでログインし、閲覧範囲の判定は各サービスが自分で持っている(営業は担当顧客だけ、など) | MCP サーバーで同じ判定を持つと 2 か所に分かれる |
非機能 | 見せてよい範囲 | 営業は担当外の顧客を見られない。今の管理画面で見られない人には見せない | 共通のサービスアカウントだけでは守れない |
機能 | 業務委託 | 業務委託の社外メンバー約30名にも、一部のサービスのデータだけ使わせたい | サービス単位でツールを開け閉めする |
非機能 | 取得の記録 | 誰がどのデータを取得したかを1年保存する | MCP サーバーが利用者を特定して記録する |
制約 | 各チームへの依頼 | 各サービスのチームに頼める改修は、1チームあたり数日程度 | 閲覧ルールの作り直しは頼めず、受け取る処理を足す程度にとどめる |
制約 | セキュリティの承認 | ISMSを取得済みで、導入前にセキュリティ部門の承認が要る | 誰の身元で何を取るかを説明できる作りにする |
それ以外の前提
どの AI クライアントから使うか、データの取り先、負荷、スキーマ変更、体制のように、どの方式を選んでも別に設計が要る前提です。
種類 | 前提 | 値 | 設計への影響 |
|---|---|---|---|
機能 | 目標 | 今は営業やCSが顧客の状況を調べるのに、複数の社内管理画面を行き来して1件あたり約10分かかる。これを1分以内にしたい | サービスをまたぐ質問に、少ない呼び出しで答える |
制約 | 対象 | 社外の人や顧客向けの利用は対象外 | 社内の IdP の利用者だけを相手にできる |
制約 | AI クライアント | 使うAIクライアントは2種類で、それぞれデスクトップ版とWeb版がある | Web 版から使うので、MCP サーバーは社内に 1 つ置く |
非機能 | 利用者 | 社員300名 | MCP サーバー自体の負荷は小さい |
非機能 | 内訳 | 内訳は営業120名、CS60名、エンジニア50名、その他70名 | 営業が使うツールから作る |
非機能 | 応答時間 | 利用するAIクライアントのタイムアウトに合わせ、ツール1回の応答は10秒以内 | 横断は並列に呼び、遅いサービスは打ち切る |
機能 | サービスの分かれ方 | サービスは約10で、顧客・契約・請求・利用状況・問い合わせなどに分かれ、各サービスが自分のDBを持つ | 横断の組み立てを MCP サーバーで行う |
機能 | 顧客 ID | 顧客IDは全サービスで共通 | 顧客 ID でサービスをまたいで突き合わせられる |
非機能 | 個人情報 | うち3つのサービスに顧客の氏名・メール・住所がある | 個人情報を返すツールと項目を絞る |
機能 | BigQuery | サービスをまたいだ分析用に、各DBをBigQueryへ日次で集めている。個人情報の列は除いてある | 集計に使えるが、前日までの値で、閲覧ルールで判定されない |
制約 | DB の直接読み | 各サービスのDBを直接読むことは、担当チームが嫌がっている | 各サービスの API を通す |
非機能 | サービスの負荷 | 各サービスは顧客からのリクエストも受けており、AIからの問い合わせで重くしない | サービスごとに呼び出しの上限を置く |
制約 | スキーマ変更 | 各サービスのスキーマは、担当チームが月に数回変える | 応答の変換をサービスごとの小さな層に閉じる |
制約 | 体制 | MCPの開発と運用はバックエンド2名とSRE 1名 | 常駐で見るサーバーを減らす |
将来 | 更新 | 営業部長はいずれ契約の更新もAIから行いたい | 身元の渡し方を更新でも使える形にしておく |
将来 | 更新の上限 | 更新を許すなら、一括での更新件数に上限がほしい(経理部の要望) | 件数の上限を MCP サーバーと契約のサービスの両方に置く |
制約 | 予算 | サーバー代などを合わせて月30万円以内 | マネージドの実行基盤で小さく動かす |
制約 | 期間 | 3か月後に営業部から先に使い始める | 営業が使うサービスから受け取る処理を足してもらう |
隠れていた前提を見直す
お題文は「各サービスのデータをまとめて検索、参照できるようにしたい。当面は読み取りだけ」としか言っていません。前提の表は、質問して初めて出てきたものです。設計への影響を見る前に、あらためて前提を読み直し、お題文の裏に何が隠れていたかを考えます。先に次の問いを考えてから、前提の表の「設計への影響」の列と見比べてください。
- 前提のうち、互いにぶつかっている 2 つの組を 3 組挙げてください。
- 閲覧の判定を MCP サーバーに持たせたい理由と、持たせたくない理由を、前提から 1 つずつ挙げてください。
- 最初の仮説 1〜4 のうち、どれがどの前提で崩れますか。
- お題文からは読み取れなかったのに、設計を一番大きく変えた前提はどれですか。
前提どうしのぶつかり
前提の多くは単独では難しくありません。難しいのは 2 つが互いに逆を向いているところで、このお題では次の 3 組です。これがそのまま、面接の後半で詳しく問われる 3 つの論点(深掘り)になります。
ぶつかる前提 | なぜぶつかるか | 解き方 |
|---|---|---|
今の管理画面で見られない人には見せない、閲覧ルールは各サービスが持つ × サービス間はサービスアカウントで認証、改修は 1 チーム数日 | 改修を少なくするなら共通のサービスアカウントで呼びたいが、そうすると閲覧ルールを MCP サーバーにも持つことになり、食い違った分だけ漏れる | 利用者の身元を各サービスまで届け、判定は今の閲覧ルールに任せる。各チームには受け取る処理だけを足してもらう |
サービスをまたぐ質問に 1 分以内で答える × BigQuery は日次で、閲覧ルールで判定されない | 横断は BigQuery が楽だが、前日までの値しか無く、営業が担当外の顧客の集計まで見られる | 今の状態と明細は各サービスの API から並列に取り、BigQuery は見られる顧客で絞った集計にだけ使う |
AI から何でも聞ける × 各サービスを重くしない、DB は直接読まない、スキーマは月に数回変わる | 自由な問い合わせを許すと、重いクエリと出し過ぎが起き、スキーマが変わるたびに AI の書く問い合わせが通らなくなる | 用途別のツールに絞り、件数と時間とサービスごとの呼び出しに上限を置く。変換はサービスごとの層に閉じる |
仮説の答え合わせ
仮説 | 崩した前提 | 置き換え |
|---|---|---|
1. ローカルの MCP サーバー | Web 版も使う、取得を 1 年記録する | 社内に 1 つ置いてデスクトップ版も Web 版もそこにつなぎ、資格情報を社員の PC に置かずに記録も 1 か所で取る |
2. 共通のサービスアカウントで MCP サーバーが絞る | 閲覧ルールは各サービスが持つ、見られない人には見せない | MCP サーバーは利用者の身元を届けてどのツールを誰に開けるかだけを決め、判定は各サービスの今の閲覧ルールに任せる |
3. 全部 BigQuery | 日次、個人情報の列が無い、閲覧ルールで判定されない | 今の状態は各サービスの API から取り、BigQuery は見られる顧客で絞った推移や件数の集計に限る |
4. AI に SQL を書かせる | DB を直接読まない、各サービスを重くしない、スキーマが月に数回変わる | 用途別のツールの中で決まった API だけを呼び、上限と打ち切りを入れる |
このお題は、各サービスの API を AI につなぐ薄い中継に見えます。しかし実際に問われるのは、今の管理画面が守っている「見られない人には見せない」を、AI という新しい入口でも同じように保ち、そのうえで各サービスを重くしない設計です。
解説:このお題の論点
論点は 3 つあり、重さの順に、誰の身元で各サービスを呼ぶか、データをどこから取るか、ツールの粒度とサービスの負荷です。どれも前提のうち 2 つが互いにぶつかっており、どちらをどう守るかを自分で決めて説明できるかが問われます。各サービスの内部の作りや、MCP のプロトコルの細かい仕様には深入りしなくて構いません。
模範解答の深掘り(5〜7)では、論点ごとに「弱い答え」「よい答え」「より良い答え」を並べ、何が足りないかを示しています。
模範解答
面接での問答の順には合わせず、このお題への答えを 1 つの設計としてまとめた解答例です。設計の筋は、MCP サーバーを社内に 1 つ置いて IdP でログインさせ、各サービスには利用者の身元を添えて API で呼び、見せてよいかの判定は今の閲覧ルールに任せる、というものです。前提に無いことは仮定として置き、その旨を書いています。
1. 作る範囲
前提を確かめたうえで、最初に作る範囲を次のように切ります。
- 作る:リモートの MCP サーバー、IdP でのログインとトークンの確認、読み取りの用途別ツール(顧客を探す、顧客の概要、契約、請求、利用状況の推移、問い合わせの履歴)、各サービスへの身元の受け渡し、サービスごとの呼び出しの上限、取得の記録(1 年)
- 作らない:更新のツール、社外や顧客向けの利用、各サービスの閲覧ルールの作り直し、各サービスのデータを集めた MCP 専用の検索用 DB
MCP サーバーは顧客データを持たず、見せてよいかの判定もしません。判定は今と同じく各サービスに任せ、MCP サーバーは誰が呼んだかを各サービスまで正しく届けて記録します。
2. 見積もり
見積もりで出すのは、構成を決める 3 つの数字だけです。どれも前提の値から計算できます。
見積もり | 計算 | 決まること |
|---|---|---|
順に呼べる回数 | 1 分 ÷ 10 秒 = 6 回 | サービスをまたぐ質問は AI に順に呼ばせず、ツールの中で並列に呼ぶ |
横断 1 回の呼び出し先 | 1 ツール × 約 10 サービス = 最大約 10 回 | 各サービスに届く量はツールの呼ばれ方で決まるので、サービスごとに上限を置く |
利用者 | 社員 300 名 + 業務委託約 30 名 = 約 330 名 | MCP サーバー自体は小さく、マネージドの実行基盤で足りる |
3. データモデル
MCP サーバーが持つのは、誰が何を取ったかの記録と、どのツールを誰に開けるかの表だけで、顧客データは持ちません。中心になる表は次の 2 つです。
表 | 主な項目 | 書き換え |
|---|---|---|
取得の記録 | 日時、利用者 ID、区分(社員、業務委託)、ツール、引数、返した顧客 ID、呼んだサービス、結果(成功、拒否、失敗) | 追記のみ。1 年残す |
ツールの公開範囲 | ツール、使うサービス、使える区分やグループ | ツールやサービスを足すときだけ |
4. 全体構成
社員の手元から社内へ入る経路は MCP サーバーの 1 つだけです。MCP サーバーは IdP のトークンで利用者を確かめ、各サービスにはその利用者の身元を添えて呼び、取ったものを記録します。
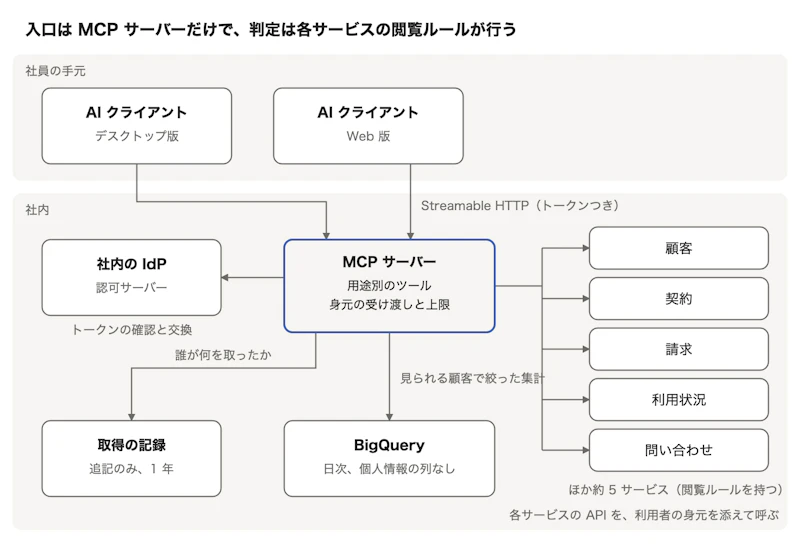
色を付けた MCP サーバーがこの設計の要で、各サービスへは必ずここを通り、利用者の身元を添えて届きます。
- AI クライアント:デスクトップ版も Web 版も、社内に置いた 1 つの MCP サーバーに Streamable HTTP でつなぎます。初回は IdP のログイン画面が開き、MCP サーバー宛てのトークンを受け取ります。
- 社内の IdP:MCP の認可サーバーの役をします。業務委託かどうかはグループで分かるようにしておきます。
- MCP サーバー(自前):トークンが自分宛てかを確かめ、利用者と区分を特定します。そのうえで、その利用者に開けたツールだけを見せ、呼ばれたら決まった API を並列に呼んで結果をまとめます。応答の変換はサービスごとの小さな層に分けます。
- 各サービスの API:利用者の身元が添えられた呼び出しを受け、今の閲覧ルールで絞った結果だけを返します。各チームに頼むのは受け取る処理を足すことだけです(5 で詳しく述べます)。
- BigQuery:利用状況の推移や件数のような集計に使います。閲覧ルールで判定されないので、先に見られる顧客を各サービスで確かめてから絞ります(6 で詳しく述べます)。
- 取得の記録:ツールを呼ぶたびに、利用者、ツール、引数、返した顧客 ID を追記のみのストレージに 1 年残します。
MCP サーバーはマネージドの実行基盤でコンテナとして動かし、2 台以上に分けて置きます。MCP の今の版はリクエストごとに必要な情報をすべて載せる作りなので、どの台が受けても処理でき、台数を増やすのも簡単です。
実例:Cloudflare は、ローカルの MCP サーバーは開発者には便利だが、端末をまたいでログインすればそのまま使えることを期待する人々に届けるにはリモートの MCP サーバーが要る、と書いています。同じ記事で、MCP サーバーは上流のサービスのトークンをそのまま渡さず、自分のトークンを AI クライアントに発行し、漏れても MCP のツールで許した範囲に限られるようにしています(Cloudflare, 2025)。Cloudflare の MCP Server Portals は、社内の IdP でログインさせ、利用者ごとに使ってよいサーバーとツールだけを見せ、MCP の呼び出しの記録を 1 か所に集めます(Cloudflare, 2025)。
代わりの案:各サービスのチームがそれぞれ MCP サーバーを作り、手前に 1 つの入口(MCP のゲートウェイ)を置いてログインと記録をまとめる構成もあります。ツールの中身をそのデータに詳しいチームが持てるので、サービスの数が増えたときには有力です。今回は、各チームに頼める改修が数日程度で、サービスをまたぐ質問を 1 回のツールで組み立てたいので、ツールは MCP サーバーに集め、各チームには受け取る処理だけを頼みます。
5. 深掘り:誰の身元で各サービスを呼ぶか
MCP サーバーは利用者の身元を添えて各サービスを呼び、見せてよいかは各サービスの今の閲覧ルールで判定させます。共通のサービスアカウントは各チームの改修が少なく済みますが、閲覧ルールが 2 か所に分かれます。最初の仮説の 2 は、ここで崩れます。MCP サーバーで絞る部分は残しますが、それは「どのツールを誰に開けるか」だけにします。
答えの段階 | 答え | 足りないところ |
|---|---|---|
弱い答え | SSO でログインさせます | ログインした後、MCP サーバーが各サービスをどの身元で呼ぶかが無い |
よい答え | 共通のサービスアカウントで呼び、MCP サーバーで担当顧客に絞ります | 閲覧ルールが 2 か所に分かれ、食い違った分だけ漏れる |
より良い答え | 利用者の身元を各サービスまで届け、今の閲覧ルールで判定させます | なし(中身は下の 5 つ) |
より良い答えの中身は次のとおりです。
- 入口では自分宛てのトークンだけを受ける:AI クライアントは IdP から MCP サーバー宛てのトークンを受け取って送ってきます。MCP サーバーは、そのトークンが自分宛てに発行されたものかを確かめ、違えば断ります。
- 受け取ったトークンを各サービスへ転送しない:MCP の仕様が禁じるトークンのパススルーにあたります。代わりに、IdP が OAuth のトークン交換に対応していれば、利用者のトークンを各サービス宛ての短い期限のトークンに替えて呼びます。このトークンには利用者が主体、MCP サーバーが代理人として書かれるので、各サービスは「MCP サーバー経由の、この利用者の呼び出し」と分かります。
- IdP が対応していないときは、利用者を署名つきで添える:今のサービスアカウントの認証はそのままにし、利用者の ID に MCP サーバーの署名を付けて添えます。この場合、署名に使う秘密が漏れるとどの利用者にもなりすませるので、その秘密は秘密情報の管理サービスに置いて定期的に替え、署名に短い期限を付けます。どちらにするかは IdP の機能を確かめて決めます(前提に無いので仮定です)。
- 各チームの改修は受け取る処理だけにする:各サービスに頼むのは、MCP サーバーからの呼び出しに限って添えられた利用者を取り出し、管理画面と同じ閲覧ルールに渡すことです。閲覧ルールそのものは書き直さないので、1 チーム数日に収まる見込みです。受け取る処理がまだ無いサービスのツールは、共通のサービスアカウントで代わりに呼ぶのではなく、出さずにおきます。3 か月後の開始に向けて、営業が使うサービスから順に頼みます。
- 業務委託はツールの公開範囲で絞る:業務委託の約 30 名には、使わせるサービスのツールだけをツールの一覧に出し、それ以外は呼ばれても断ります。ツールの公開範囲と各サービスの閲覧ルールの両方で絞ることになります。業務委託も社内の IdP でログインできると仮定しています。
取得の記録は MCP サーバーで取り、各サービスにも添えられた利用者が残るので、「誰がどのデータを取得したか」はどちらからでも追えます。この作りはセキュリティ部門に説明するときにも、「今の管理画面と同じ閲覧ルールを通っている」と一言で言えます。
実例:MCP の認可の仕様は、MCP サーバーをトークンを受け取って確かめる側(OAuth のリソースサーバー)とし、自分宛てに発行されたトークンだけを受け、それ以外のトークンを受け取ることも転送することもしてはならないと定めています(MCP Authorization)。トークンを転送すると、各サービスがどこを通った呼び出しかを区別できず、記録と調査が難しくなることは MCP Security Best Practices にあります。主体と代理人の両方を 1 つのトークンに書く委任は、OAuth のトークン交換の仕様が定めています(RFC 8693, 2020)。
6. 深掘り:データの取り先
今の状態と明細は各サービスの API から取り、BigQuery は推移や件数のような集計にだけ使います。サービスをまたぐ質問は、AI に順に呼ばせず、MCP サーバーのツールの中で顧客 ID をもとに組み立てます。
答えの段階 | 答え | 足りないところ |
|---|---|---|
弱い答え | 各サービスの API から取ります | サービスをまたぐ集計をどうするかと、BigQuery と比べた理由が無い |
よい答え | 新しさが要る明細は API、サービスをまたぐ集計は BigQuery と使い分けます | BigQuery では閲覧ルールで判定されないので、営業が担当外の顧客の集計まで見られる |
より良い答え | 使い分けたうえで、横断は MCP サーバーで組み立て、BigQuery は見られる顧客で絞ってから使います | なし(中身は下の 4 つ) |
- 横断の質問は 1 つのツールで答える:「この顧客の契約と利用状況」なら、顧客の概要のツールが顧客、契約、請求、利用状況、問い合わせの API を顧客 ID で並列に呼び、1 つの結果にまとめます。AI に 5 回呼ばせると、それだけで 1 分の目標を使い切りかねません。
- 10 秒に収める:各サービスへの呼び出しに数秒の上限を置き、間に合わなかったサービスは「取れなかった」と明示して残りを返します。空の結果と取れなかった結果を分けて返すので、AI が「契約は無い」と言い切ることを防げます。
- BigQuery は見られる顧客で絞る:BigQuery には各サービスの閲覧ルールがありません。そこで、集計のツールは先に顧客のサービスへ利用者の身元を添えて「この利用者が見られる顧客 ID」を問い合わせ、その ID で BigQuery を絞ります。全社の合計のように個人を特定しない集計は、ツールごとに使える区分を決めて開けます。
- 新しさを結果に書く:BigQuery から取った値には「前日時点」と添えて返します。AI が今日の値と取り違えないようにするためです。
BigQuery にも行単位で見せる範囲を絞る機能があります。ただし、それを使うと閲覧ルールを BigQuery にもう 1 つ持つことになり、5 で避けた「2 か所に分かれる」問題が戻ってきます。今回は閲覧ルールを各サービスの 1 か所に保つほうを選びます。
実例:BigQuery の行レベルのアクセス ポリシーは、許可する相手の一覧と、WHERE 句のように見せる行を決める条件の組で、一覧に無い人には行が見えません(Google Cloud)。営業ごとの担当顧客をここで表すには、各サービスの閲覧ルールを BigQuery の条件に写し続ける必要があります。
7. 深掘り:ツールの粒度とサービスの負荷
AI に自由な問い合わせを許さず、用途別のツールに絞ります。そのうえで、ツール 1 回あたりに各サービスへ届く量に上限を置きます。
答えの段階 | 答え | 足りないところ |
|---|---|---|
弱い答え | ツールを作ります | どんな粒度のツールか、なぜそうするかが無い |
よい答え | 自由な SQL をやめ、用途別のツールにします | AI が同じツールを何十回も呼べば、各サービスが重くなる |
より良い答え | 用途別のツールに、件数、時間、サービスごとの呼び出しの上限を付け、変換をサービスごとの層に閉じます | なし(中身は下の 4 つ) |
- ツールは営業と CS の調べものの単位で作る:顧客を探す、顧客の概要、契約の一覧、請求の状況、利用状況の推移、問い合わせの履歴のように、管理画面を行き来していた手順を 1 つずつツールにします。API を 1 つずつ包んだツールにすると、AI が何回も呼ぶことになり、時間もサービスの負荷も増えます。
- 返す量を決めておく:顧客を探すツールは件数の上限を決め(たとえば 20 件)、続きはページ送りにします。個人情報を持つ 3 つのサービスからは、ツールが必要とする項目だけを返します。たとえば顧客の概要には氏名を出しますが、住所は出しません。
- サービスごとに呼び出しの上限を置く:MCP サーバーから各サービスへの同時に呼べる数と、1 秒あたりの数に上限を置きます。上限を超えた呼び出しは待たせずに断り、AI には「少し待ってから」と返します。利用者ごとにも 1 分あたりの呼び出し数に上限を置き、AI が同じツールを繰り返し呼び続ける場合に備えます。
- スキーマ変更をサービスごとの層で受ける:MCP サーバーは DB を読まず、各サービスの API の応答だけを読みます。応答をツールの形に直す処理はサービスごとの層に分け、各サービスの変更はその層を直すだけで済むようにします。応答が想定の形でないときは、空の結果ではなく失敗として返し、気づけるようにします。
この構成で最初に詰まるのは MCP サーバーではなく、顧客からのリクエストも受けている各サービスです。サービスごとの上限は、各チームと話して余裕に合わせて決めます。
実例:Anthropic は、エージェント向けのツールは API をそのまま包むのではなく、人が仕事を分けるのと同じ単位でまとめるよう勧めています。返す量はページ送り、絞り込み、切り詰めと妥当な初期値で抑えるべきで、Claude Code はツールの応答を初期設定で 25,000 トークンまでに制限していると書いています(Anthropic, 2025)。Block は 60 を超える MCP サーバーを作った経験から、API ごとではなく仕事の流れを起点にツールを設計し、返す前に大きさを測るよう勧めています。Linear 用のサーバーは 30 を超えるツールから、読み取り専用の問い合わせを受ける 1 つのツールへ移りました(Block, 2025)。これは問い合わせ先が 1 つの API にまとまっている場合の話で、作りがばらばらで DB を直接読めない今回の前提では、用途別のツールのほうが合います。
8. 障害への備えと監視
どこが止まっても、社員は今の管理画面で調べられます。そのうえで、取得の記録が取れないときは、データを返さないほうを選びます。
止まるもの | 社員に見えること | 手当て |
|---|---|---|
1 つのサービスの API | そのサービスの分だけ「取れなかった」と出る | 時間の上限で打ち切って残りを返し、失敗が続くサービスはしばらく呼ばない |
サービスの過負荷 | 「少し待ってから」と返る | サービスごとの上限で断り、顧客からのリクエストを守る |
社内の IdP | 新しくログインできない | 受け取り済みのトークンは期限まで使え、新しいログインは復旧を待つ |
BigQuery の日次の取り込み | 集計が古い日付のまま出る | 結果に何日時点の値かを添え、決めた日数より古ければ集計のツールを止める |
取得の記録の書き込み | ツールが失敗する | 1 年の記録を欠かさないため、記録できないときはデータを返さない |
MCP サーバー | AI から使えない | 2 台以上に分けて置き、それでも止まれば管理画面で調べてもらう |
監視するのは、ツールごとの応答時間(10 秒に近づいていないか)、サービスごとの呼び出し数と失敗の率、上限で断った数、閲覧ルールで拒否された数、取得の記録の書き込み失敗です。拒否が急に増えたときは、閲覧ルールか身元の受け渡しが変わっていないかを確かめます。
9. 条件の変更への対応
面接の後半では、運用で起きた不具合や将来の要望という形で条件が足されます。答え方は、今の設計でなぜ起きたか、何をきっかけに何をどう処理して直すか、変えずに済むところはどこか、の順です。
例 1:利用状況のサービスがスキーマを変えたあと、AI が「この顧客の利用は無い」と答えていた
- 原因:利用状況の API の応答で項目の名前が変わり、変換の層がその項目を見つけられず、空の結果として返していた。
- 直し方:変換の層で、想定の項目が無い応答は空ではなく失敗として返し、AI には「取れなかった」と伝えます。そのうえで、MCP サーバーが使う項目を各サービスとの約束としてテストにし、各サービスのリリース前のテストで流してもらいます。項目が変わるときは、テストが落ちた時点で MCP 側を先に直せます。
- 変えずに済むところ:身元の渡し方、取得の記録、ほかのサービスの変換の層です。
例 2:営業部長が、契約の更新も AI から行いたいと言ってきた
- 影響:今は読み取りだけなので、更新の誤りや二重の実行への備えがありません。AI が誤って何件もまとめて更新するおそれもあります。
- 直し方:契約を更新するツールを足し、使える人を絞り、ログインのときに読み取りとは別の権限を求めます。実行の前に、AI クライアントを通して利用者に内容の確認を求めます。一括で更新できる件数の上限は、MCP サーバーと契約のサービスの両方に置きます。同じ依頼が 2 回届いても 1 回だけ反映されるよう、依頼ごとに一意の ID を付けて契約のサービスで重複を除きます。
- 変えずに済むところ:身元の渡し方です。利用者の身元が契約のサービスまで届いているので、更新できるかどうかも契約のサービスの今の権限の判定に任せられます。共通のサービスアカウントで呼んでいたら、ここで権限の判定を MCP サーバーに作り直すことになります。
まとめ:選んだものと捨てたもの
判断 | 選んだ案 | 捨てた案、代わりの案 | 理由 |
|---|---|---|---|
置き方 | 社内に 1 つのリモートの MCP サーバー(Streamable HTTP) | 社員の PC で動くローカルの MCP サーバー(stdio) | Web 版から使え、資格情報を社員の PC に置かず、記録を 1 か所で取れる |
入口の認可 | 社内の IdP を認可サーバーにした OAuth | MCP サーバー独自のログイン | 全社員がすでに SSO でログインしている |
各サービスを呼ぶ身元 | 利用者の身元を添える委任(トークン交換、無理なら署名つき) | 共通のサービスアカウントと MCP での絞り込み、トークンの転送 | 閲覧ルールを各サービスの 1 か所に保つ。トークンの転送は仕様で禁止 |
データの取り先 | 今の状態と明細は API、集計は見られる顧客で絞った BigQuery | 全部 BigQuery、DB の直接読み | 新しさと閲覧ルールを守り、担当チームの意向に沿う |
ツールの粒度 | 調べものの単位の用途別ツールと上限 | 自由な SQL、API ごとのツール | 出し過ぎと重いクエリを防ぎ、10 秒と 1 分に収める |
ツールの置き場所 | MCP サーバーに集める | 代わりの案:各チームが MCP サーバーを作り、ゲートウェイでまとめる | 各チームの改修は数日程度で、横断を 1 回のツールで組み立てたい |
記録が取れないとき | データを返さない | 記録を諦めて返す | 誰が何を取ったかの 1 年の記録を欠かさない |
よくあるつまずき
つまずき | なぜ弱いか | 抜け出す一手 |
|---|---|---|
面接の最初から構成図を話し始める | 閲覧ルールの持ち主や業務委託のように、設計を決める条件を取りこぼす | 誰が使うか、何を見せてはいけないか、各サービスの認証の今を先に聞く |
「SSO でログインさせる」で認可を終える | MCP サーバーから各サービスをどの身元で呼ぶかが抜けている | 入口の認可と、各サービスを呼ぶ身元を分けて話す |
MCP サーバーが全データを取れる前提で話す | 営業の担当外の顧客が AI からは見えてしまう | 今の管理画面と同じ閲覧ルールを、どこで通すかを言う |
受け取ったトークンを各サービスに転送する | MCP の仕様で禁じられており、どこを通った呼び出しか区別できなくなる | トークン交換か、署名つきで利用者を添える |
BigQuery で全部まかなう | 前日までの値で、閲覧ルールで判定されない | 今の状態は API から取り、BigQuery は絞った集計に限る |
AI に SQL を書かせる | DB を直接読めず、重いクエリとスキーマ変更に弱い | 調べものの単位の用途別ツールにする |
ツールを用途別にしたところで終える | AI が何十回も呼べば、やはり各サービスが重くなる | 件数、時間、サービスごとの呼び出しに上限を置く |
MCP のプロトコルの細部を長く話す | このお題で問われているのは身元とデータの取り先で、時間が足りなくなる | 通信方式は Web 版から使えるかで決め、すぐ認可の話に移る |
▼解説を読んだら、同じお題を AI 面接官を相手に通しで解いてみましょう。
参照元
MCP の公式の仕様と、技術ブログ、技術文書です。どれも開いて内容を確かめています。MCP の仕様は 2026-07-28 版を読みました。Cloudflare と Google Cloud の記事は自社製品の紹介を兼ねています。
節 | 記事 | 参照した内容 |
|---|---|---|
事前知識 | ホスト、クライアント、サーバーの役割。stdio のローカルと Streamable HTTP のリモート。ツールと tools/call。リクエストごとに必要な情報を載せる作り | |
事前知識 | Transports(MCP) | stdio と Streamable HTTP の 2 つの通信方式 |
事前知識、5 | Authorization(MCP) | HTTP では OAuth に従い、stdio では資格情報を環境から取る。MCP サーバーはリソースサーバーで、自分宛てのトークンだけを受ける |
事前知識、5 | トークンのパススルーの禁止と、その理由 | |
事前知識、5 | RFC 8693: OAuth 2.0 Token Exchange(IETF, 2020) | トークン交換と、主体と代理人を書く委任 |
4 | Build and deploy Remote Model Context Protocol (MCP) servers to Cloudflare(Cloudflare, 2025) | リモートの MCP サーバーが要る理由と、上流のトークンを渡さず自分のトークンを発行する作り |
4 | Securing the AI Revolution: Introducing Cloudflare MCP Server Portals(Cloudflare, 2025) | 社内の IdP でのログイン、利用者ごとのツールの出し分け、記録の集約 |
6 | Introduction to BigQuery row-level security(Google Cloud) | 行レベルのアクセス ポリシーの仕組み |
7 | Writing effective tools for AI agents(Anthropic, 2025) | API を包まず仕事の単位でまとめる。返す量の抑え方と 25,000 トークンの初期値 |
7 | Block's Playbook for Designing MCP Servers(Block, 2025) | 仕事の流れからのツール設計、返す前に大きさを測る、Linear 用サーバーのまとめ方 |
▼ほかのお題の解説
サカモトエンジニア監修
外資系企業のソフトウェアエンジニア。エンジニアのキャリアや面接について X や note で発信し、テック企業を目指すエンジニア向けの面接対策プラットフォーム InterviewCat を運営しています。

公式アカウント
CaseMatch編集部
CaseMatch編集部は、就活・転職における面接対策やキャリア選択に役立つ情報を発信する編集チームです。AI面接練習サービス「CaseMatch」の運営で得た知見や、企業選考・ケース面接・自己分析に関する実践的なノウハウをもとに、候補者が納得感を持って選考に臨めるコンテンツをお届けします。
面接練習で、選考を有利に進めよう。

1分で完了


