
ケース面接
2026/11/03
技術設計面接の解説と模範解答|議事録テイカー
目次
技術設計面接(システムデザイン面接)のお題「議事録テイカー」を題材に、事前に押さえておく知識、面接で引き出せる前提、論点、模範解答、よくあるつまずきを順に解説します。
ほかのお題の解説は技術設計面接の解説と模範解答まとめにあります。
より詳しい情報はこちら
この記事で使う設計の基礎は、日本語のシステムデザイン面接の教材 SystemDesign InterviewCat で詳しく学べます。この記事の各節に関係する章は次のとおりです。
InterviewCat の章 | この記事で関係する節 |
|---|---|
SystemDesign InterviewCat の全体像 | |
面接で見られることと進め方 | |
4. 全体構成(スマホアプリからのチャンクの送信) | |
4. 全体構成(録音とチャンクの置き場所) | |
4. 全体構成、5. 音声処理の流れ(ジョブキューとワーカー) | |
5. 音声処理の流れ(終了が集中したときに待たせる) | |
事前知識、5. 音声処理の流れ(チャンクの並列処理) | |
9. 会議中の要約 | |
8. 障害への備え(外部 API の再試行と二重処理の防止) | |
3. データモデル、7. 認識誤りの補い方(顧客ごとの辞書と保持期間) |
事前知識:音声をいつ処理するかと最初の仮説
設計面接では、お題を聞いた時点で「たぶんこの作りだろう」という仮説を持ち、前提を聞くたびにそれを確かめたり崩したりします。議事録のお題なら、まず「録音をいつ、どの単位で文字にするか」の選択肢を押さえておきます。会議が終わってからまとめて処理するか、会議中から少しずつ処理するかの選択で、要約が届くまでの時間がほぼ決まるためです。
録音が議事録になるまでの流れ
録音は次の順に処理されて議事録になります。どの方式でも、文字にして、話者を分けて、要約する順番は同じです。違うのは、それをいつ、どの大きさで動かすかです。
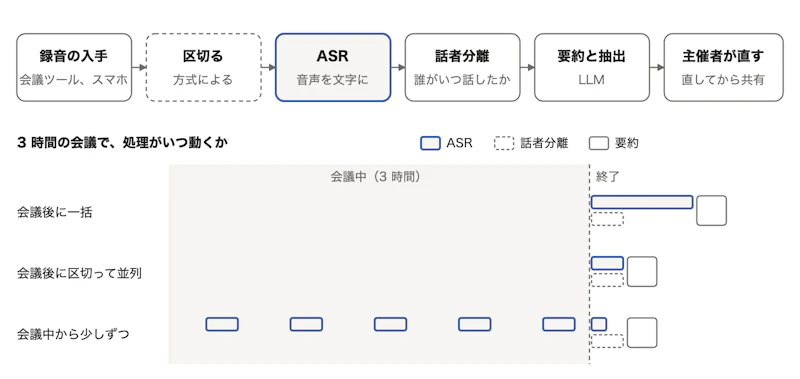
- ASR:音声認識(Automatic Speech Recognition)。音声を文字にする処理で、今回は外部の API を使う
- 話者分離:録音のどの時間帯を誰が話したかを分ける処理。分かるのは「話者 A」「話者 B」の区別までで、名前は別に付ける
- チャンク:録音を区切ってできた数分ほどの断片。区切ってから先の処理は、チャンクを単位に進める
ASR、話者分離、要約は、どれも録音や文字起こしの長さにおおむね比例して時間がかかります。そのため、終了のあとに残る仕事を短くするには、終了より前に済ませるか、終了のあとに並べて同時に進めるかのどちらかが要ります。
それぞれの方式で何が起きるか
同じ 3 時間の会議を処理するとき、方式ごとに裏で起きることを並べます。
会議後に一括:会議が終わって録音がそろったら、録音全体を 1 本のまま ASR に渡し、返ってきた文字起こし全体を LLM で要約します。仕組みが一番単純で、録音全体を見て処理できるので話者の区別もそろいます。弱いところは、待ち時間が録音の長さと外部 API の速さに任せきりになることです。途中で失敗すると最初からやり直しで、ファイルの大きさの上限で 1 本では渡せないこともあります。
会議後に区切って並列:録音がそろったら、無音の位置でチャンクに区切り、チャンクごとの ASR を同時に進めます。チャンクが 10 個なら、ASR にかかる時間はおよそ 1 個分で済みます。失敗したチャンクだけをやり直せます。一括と比べた弱みは 2 つあります。区切りの境目で語や文が切れやすいことと、チャンクごとに話者分離をすると、あるチャンクの「話者 A」と次のチャンクの「話者 A」が同じ人とは限らないことです。会議の終了が集中する時間帯には、並列に動かす数が一気に増えます。
会議中から少しずつ:会議中に数分ごとのチャンクを受け取り、受け取ったそばから ASR を済ませておきます。終了の時点で残るのは、最後のチャンクと全体の要約だけなので、会議の長さに関わらず待ち時間が短くなります。途中までの文字起こしがあるので、会議中に途中までの要約を見せることもできます。チャンクに区切るので、境目で語が切れることと、チャンクごとに話者分離をしたときの話者のずれは、区切って並列と同じ弱みです。もう 1 つの弱みは、会議中に音声を受け取る手段が要ることです。会議ツールの録音は多くの場合、会議が終わってから取り出せるようになります。会議中の音声は、ボットを会議に参加させるか、会議ツールが会議中の音声をアプリへ渡す仕組みを使って受け取り、どちらも会議ツールごとに作りが違います。
リアルタイム字幕(ストリーミング ASR):発話のたびに 1 秒以内で文字にして返し続けます。会議中の字幕や音声アシスタントに向いています。後で録音全体を見て処理する方式より精度が下がりやすく、話している間ずっと接続を保つ必要があります。議事録のように数分遅れてよい用途では、少しずつ処理する方式で足ります。
方式の名前より、比べたいのは、録音をどの大きさに区切り、終了の前と後のどちらで文字にするかです。チャンクを単位にしておけば、録音が終了後にまとめて届いても、会議中に少しずつ届いても、区切ってから先は同じ仕組みで処理できます。
方式を比べる
方式の違いは、「3 時間の会議が終わったとき」と「会議の終了が集中したとき」の 2 つの場面に、「会議中に要約を見せられるか」を加えて比べると分かりやすくなります。
方式 | 3 時間の会議が終わってから要約が届くまで | 会議の終了が集中したとき、裏側の仕事は | 会議中に途中までの要約を見せられるか |
|---|---|---|---|
会議後に一括 | 録音全体の ASR、話者分離、要約の時間(外部 API の速さ次第) | 長いジョブが終了と同時にまとめて積まれる | できない |
会議後に区切って並列 | チャンク 1 個分の ASR、録音全体の話者分離、要約の時間 | チャンクの数だけ短いジョブが一気に積まれる | できない |
会議中から少しずつ | 最後のチャンクの ASR、録音全体の話者分離、要約の時間 | 会議中に分散しているので、終了時の仕事は少ない | できる |
リアルタイム字幕 | 要約の時間 | 会議の間ずっと接続と処理が続く | できる |
表から分かるとおり、待ち時間を短くする方法は、終了後の仕事を並べて同時に進めるか、終了前に済ませておくかの 2 つです。会議中から少しずつ処理する方式は両方の点で有利ですが、会議中に音声を受け取れることが条件になります。今回のお題では、音声の入り方がオンライン会議と対面とで違うので、方式を 1 つに決めるのではなく、入り方ごとに選ぶことになります。
最初の仮説
お題文だけを読んだ段階では、次の仮説を置きがちです。どれも筋は悪くありませんが、前提を聞くと一部が崩れます。答え合わせは「隠れていた前提を見直す」で行います。
仮説 | 中身 | 確かめること |
|---|---|---|
1 | 会議が終わったら、録音を 1 本のまま ASR に渡し、続けて要約すればよい | 最長の会議の長さ、要約が届くまでに許される時間、終了が集中する時間帯 |
2 | 文字起こし全体を LLM に 1 回で渡せば、要約とタスクがまとめて取れる | 会議の長さ、誤りが許されない項目、要約から何を取り出すか |
3 | ASR の精度は十分なので、誤りは主催者が直せばよい | 固有名詞の多さ、修正に使える時間、話者を区別しにくい会議があるか |
4 | 会議ツールの録音を取り込めば、どの会議も同じ形で扱える | 会議の内訳、録音の取り出し方、対面の会議の録り方 |
お題と要件
面接官から示されるお題は次のとおりです。
本日はシステムの設計方法についてディスカッションしたいと思います。今、会議の議事録を自動で作るツールを作ることを考えています。Zoom・Teams・対面の会議を文字起こしして要約とタスクを作り、参加者が修正してから共有できるようにしたいです
▼このお題は CaseMatch の AI 面接で、面接官に前提を質問しながら練習できます。
前提は質問すれば答えてもらえます。面接で引き出せる前提を、音声をいつ処理するかの選び方に関わるものとそれ以外に分けて並べます。種類の列は、機能要件、非機能要件、制約、将来の要望のどれにあたるかです。値の列は面接官の答えそのままです。設計への影響の列は、次の節の問いを考えてから読んでください。
音声をいつ処理するかの選び方に関わる前提
事前知識の比較表の 3 つの比べ方(終了から要約までの時間、終了が集中したときの裏側の仕事、会議中に要約を見せられるか)と、音声の入り方、費用を決める前提です。
種類 | 前提 | 値 | 設計への影響 |
|---|---|---|---|
非機能 | 要約が届くまで | 終了後10分以内に要約が届く | 1 本で処理すると、間に合うかが外部 API の速さに左右される |
非機能 | 会議の長さ | 最長3時間 | 終了後に残る仕事を録音の長さに比例させない |
非機能 | 会議の数 | 1日約2,000会議、平均1時間 | ASR の費用は音声の長さで決まるので、送る量を減らす |
非機能 | 集中する時間帯 | 会議の開始は平日の10〜11時と14〜16時に集中し、多い時間帯は1時間に約400会議 | 終了も集中するので、キューで受けて並列数を増減する |
機能 | 字幕 | 会議中のリアルタイム字幕は作らない | ストリーミング ASR は要らない |
将来 | 会議中の要約 | 会議中にも要約を見たいという要望が大口顧客から出ている | 会議中に音声を受け取る取り込み元を後から足せる形にする |
機能 | 会議の内訳 | 内訳はオンライン7割(Zoom 6割・Teams 4割)、対面3割 | 取り込み元が 3 つある |
制約 | オンライン会議の録音 | オンライン会議の録音を取り出す方法は会議ツールごとに異なり、顧客企業の管理者の許可が要る場合がある | 取り込みを会議ツールごとの部品に分け、区切ってから先を共通にする |
制約 | 対面の録音 | 対面はスマホアプリで録音する。電波の弱い会議室があり、録音後にまとめてアップロードすることがある | アプリからチャンクで送り、送れない分は端末にためて後から送る |
制約 | 音声認識 | 音声認識は外部APIを使い、費用は音声1時間あたり約100円 | 同じ音声を 2 回 ASR に通さない |
制約 | 費用 | 音声認識とLLMの費用は売上の20%以内に収める | 無音を ASR に送らず、LLM に渡す量を絞る |
将来 | 会議数の伸び | 1年後に会議数が今の20倍になる見込み | ワーカーの数と外部 API の上限を増やせる形にする |
それ以外の前提
誤りの扱い、話者、保持と削除、権限のように、どの方式を選んでも別に設計が要る前提です。
種類 | 前提 | 値 | 設計への影響 |
|---|---|---|---|
機能 | 目標 | 今は主催者が手で議事録を書き、1会議あたり約30分かかっている。修正にかかる時間を平均10分以内にしたい | 直す箇所が少なく、直しやすい画面が要る |
非機能 | 誤りの重さ | 要約とタスクの中で、社名・担当者・期日の誤りは問題になる。それ以外の言い回しの誤りは許容する | この 3 項目だけは要約と別に取り出して確かめる |
機能 | 利用企業 | 法人向けSaaSで約300社が利用、1社あたり数十〜数千名 | 辞書、保持期間、録音しない設定を顧客ごとに持つ |
機能 | 参加者 | 参加者は平均5名、最大20名 | 話者分離に渡す話者数の上限を決められる |
機能 | 言語 | 日本語が中心で、約1割の会議は英語が混ざる | 1 つの会議で言語が混ざっても扱える ASR を選ぶ |
非機能 | 固有名詞 | 顧客社名・製品名・業界用語が多く誤認識が多い | ASR の結果をそのまま使えない |
機能 | 用語辞書 | 用語辞書は顧客ごとに最大5,000語まで登録できる | ASR のヒントに全部は入らないことがある |
制約 | 対面の話者 | 対面は会議室のマイク1本で話者の区別が難しい | 話者の名前を人が付け替えられる画面が要る |
機能 | 発言者 | 誰の発言かを議事録に残す | 話者分離に加えて、話者に名前を付ける仕組みが要る |
制約 | 保持と削除 | 録音の保持期間は顧客ごとに30日〜無期限で選べ、削除依頼には即日で応じる | 録音から作ったものまで会議単位で消せるようにする |
制約 | 録音しない会議 | 人事や M&A の会議は録音しない設定が必要 | 取り込む前に判定する |
制約 | 録音の通知 | 会議の冒頭で、録音していることを参加者に通知する | 取り込み元ごとに通知の手段を持つ |
機能 | 修正と共有の権限 | 議事録を修正して共有できるのは主催者のみ | 会議ごとに主催者を記録する |
機能 | 共有先 | 共有先は社内チャット・メール・社内Wiki | 共有先ごとの送り出しを非同期にする |
隠れていた前提を見直す
お題文は「文字起こしして要約とタスクを作り、修正して共有する」としか言っていません。前提の表は、質問して初めて出てきたものです。設計への影響を見る前に、あらためて前提を読み直し、お題文の裏に何が隠れていたかを考えます。先に次の問いを考えてから、前提の表の「設計への影響」の列と見比べてください。
- 前提のうち、互いにぶつかっている 2 つの組を 3 組挙げてください。
- 3 時間の会議を終了後 10 分で処理し終えるには、録音の何倍の速さが要りますか。その速さを出す方法を 2 つ挙げてください。
- 最初の仮説 1〜4 のうち、どれがどの前提で崩れますか。
- お題文からは読み取れなかったのに、設計を一番大きく変えた前提はどれですか。
前提どうしのぶつかり
前提の多くは単独では難しくありません。難しいのは 2 つが互いに逆を向いているところで、このお題では次の 3 組です。これがそのまま、面接の後半で詳しく問われる 3 つの論点(深掘り)になります。
ぶつかる前提 | なぜぶつかるか | 解き方 |
|---|---|---|
最長 3 時間 × 終了後 10 分以内(多い時間帯は 1 時間に約 400 会議) | ASR も要約も録音の長さに比例して時間がかかり、1 本で処理すると長い会議ほど遅れる | 録音をチャンクに区切って並列に処理し、会議中に届く音声は届いたそばから処理しておく |
最長 3 時間の文字起こし × 社名、担当者、期日の誤りは問題 | 長い文字起こしを 1 回で要約すると、中ほどの決定やタスクが抜けたり、担当者や期日が混ざったりする | 区切って要約したうえで、決定事項とタスクと担当者と期日は要約とは別に取り出し、元の発言に結び付ける |
固有名詞の誤認識が多い、対面は話者を区別しにくい × 修正を平均 10 分以内に | 誤りを全部主催者に直させると、手で書いていたときと手間が変わらない | 用語辞書を ASR と認識後の置き換えの両方に使い、主催者の修正を辞書に返す。話者の名前は 1 回の指定で全発言に反映する |
仮説の答え合わせ
仮説 | 崩した前提 | 置き換え |
|---|---|---|
1. 録音を 1 本のまま処理 | 3 時間の録音は上限で 1 本で渡せないことがある、失敗時のやり直し、終了の集中 | 録音をチャンクに区切って並列に処理する。対面のスマホアプリからは会議中からチャンクで受け取り、届いたそばから処理する |
2. 全体を 1 回で要約 | 最長 3 時間、社名と担当者と期日の誤りは問題 | 区切って要約し、最後にまとめる。決定事項とタスクは要約とは別の形式で取り出し、根拠の発言を残す |
3. 誤りは主催者が直す | 固有名詞の誤認識が多い、修正を平均 10 分以内、対面はマイク 1 本 | 直す箇所を辞書で減らし、残った誤りは直す場所が分かる画面で直させる。直した結果は辞書に返す |
4. 会議ツールの録音を同じ形で取り込む | 取り出し方が会議ツールごとに違う、管理者の許可、対面はスマホで後からまとめて届く | 取り込み元は 3 つに分け、どれもチャンクにしてから先を同じ流れにする |
このお題は録音を AI に渡すだけのツールに見えます。しかし実際に問われるのは、3 時間の会議を終了後 10 分で、しかも社名や期日を誤らずに主催者へ届けるために、録音と文字起こしをどこで区切り、何を別に取り出すかの設計です。
解説:このお題の論点
論点は 3 つあり、重さの順に音声処理の流れ、取りこぼさない要約、認識誤りの補い方です。音声処理の流れでは、取り込みから ASR、話者分離、要約までを終了後 10 分以内に収めるために、どこで区切って非同期にするかを説明できるかが問われます。続く 2 つは、長い会議の要約から決定事項やタスクを落とさない方法と、固有名詞や対面の話者の誤りを辞書と人の修正で補う方法です。Zoom や Teams との連携の細かい手順には深入りしなくて構いません。
模範解答の深掘り(5〜7)では、論点ごとに「弱い答え」「よい答え」「より良い答え」を並べ、何が足りないかを示しています。
模範解答
面接での問答の順には合わせず、このお題への答えを 1 つの設計としてまとめた解答例です。設計の筋は、取り込み元がどこであっても録音を数分のチャンクにそろえ、チャンクごとの ASR を並列に進め、話者分離は録音全体で 1 回だけ行い、要約とは別に決定事項とタスクを取り出す、というものです。前提に無いことは仮定として置き、その旨を書いています。
1. 作る範囲
前提を確かめたうえで、最初に作る範囲を次のように切ります。
- 作る:Zoom と Teams の録音の取り込み、スマホアプリでの対面の録音、録音しない設定と録音の通知、ASR と話者分離、要約と決定事項とタスクの抽出、顧客ごとの用語辞書、主催者の修正画面、社内チャットとメールと社内 Wiki への共有、保持期間と削除
- 作らない:会議中のリアルタイム字幕、会議中の要約(後から足せる形にだけしておく)、ASR と LLM のモデルそのもの、会議ツールのアプリ内の画面
設計の要は、取り込み元を会議ツールごとに分け、チャンクにしてから先を 1 つの流れにそろえることです。
2. 見積もり
見積もりで出すのは、構成を決める 3 つの数字だけです。どれも前提の値から計算できます。
見積もり | 計算 | 決まること |
|---|---|---|
必要な速さ | 180 分 ÷ 10 分 = 18 倍 | 要約まで含めて録音の 18 倍より速く終える必要があり、1 本では外部 API の速さ次第なので、区切って並列にするか会議中に済ませておく |
同時に進む会議 | 1 時間に約 400 会議 × 平均 1 時間 = 同時に約 400 会議(1 年後 約 8,000) | 終了も 1 時間に約 400 会議集まるので、キューで受けてワーカーの数を増減し、外部 API の同時実行の上限を先に確かめる |
ASR の費用 | 2,000 会議 × 1 時間 × 100 円 = 1 日約 20 万円(1 年後 約 400 万円) | 無音の区間は送らず、再試行で同じチャンクを 2 回 ASR に通さない |
3. データモデル
文字起こしは発言の単位で持ち、要約やタスクの各項目は、根拠になった発言を指すようにします。中心になる表は次の 4 つです。
表 | 主な項目 | 書き換え |
|---|---|---|
会議 | 会議 ID、顧客 ID、主催者、取り込み元(Zoom、Teams、対面)、状態、保持期限 | 状態だけを進める |
チャンク | 会議 ID、連番、録音の中の開始と終了の時刻、保存先、ASR の状態 | ASR の状態だけを進める |
発言 | 発言 ID、会議 ID、開始と終了の時刻、話者ラベル、話者名、ASR の結果、主催者が直した本文 | ASR の結果は残し、直した本文を別に持つ |
議事録の項目 | 項目 ID、会議 ID、種類(要約、決定事項、タスク)、本文、担当者、期日、根拠の発言 ID、主催者の確認済みの印 | 主催者だけが直す |
すべての表に顧客 ID か会議 ID を持たせるので、保持期限を過ぎたときや削除依頼が来たときは、会議 ID をたどって録音から議事録まで残らず消せます。ASR の結果を残しておくのは、主催者が何をどう直したかを辞書の改善に使うためです。
4. 全体構成
取り込み元は 3 つありますが、録音をチャンクにして置き場所に置き、ジョブキューに知らせてから先は、どの取り込み元でも同じ流れです。重い処理はすべてキューの先のワーカーで非同期に進めます。
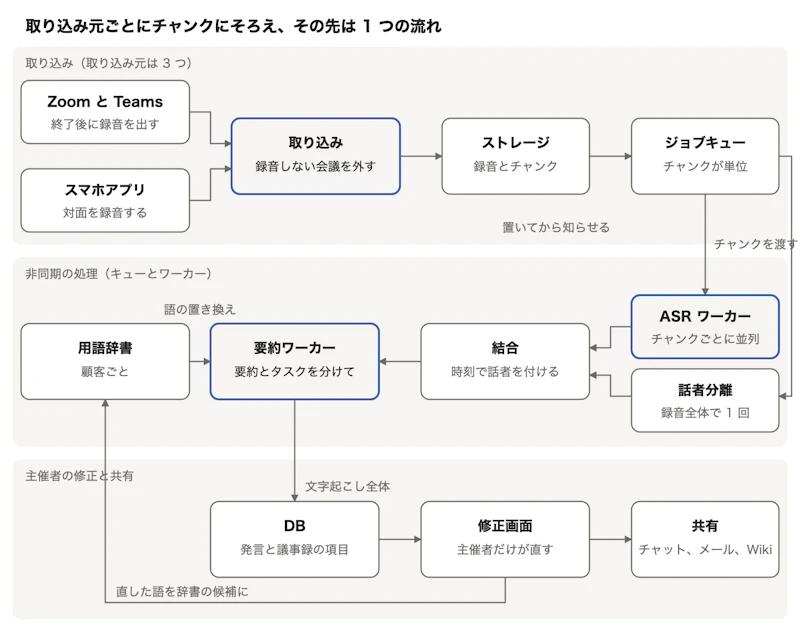
色を付けた 3 つの部品(取り込み、ASR ワーカー、要約ワーカー)がこの設計の要で、待ち時間と誤りの多さはここで決まります。
- 取り込み:Zoom は録音の準備ができたときの通知を、Teams は録音や文字起こしができたときの変更通知を受けて、録音を取りに行きます。スマホアプリは会議中から数分ごとのチャンクを送り、電波が弱くて送れない分は端末にためて、つながってから送ります。どの取り込み元でも、受け取る前に顧客の設定を見て、録音しない会議は取り込みません。
- ストレージとジョブキュー:録音とチャンクをオブジェクトストレージに置いてから、チャンク 1 つを 1 件のジョブとしてキューに入れます。オンライン会議の録音は、取り込みで無音の位置で区切ってからチャンクにします。
- ASR ワーカー:チャンクごとに外部の ASR API を呼び、結果をチャンクの番号つきで保存します。チャンクが並列に処理されるので、3 時間の会議でもかかる時間はチャンク数個分です。
- 話者分離:録音全体がそろったら、録音全体に対して 1 回だけ行います。チャンクごとに行うと、チャンクをまたいで話者のラベルがそろわないためです。
- 結合と要約ワーカー:ASR の結果と話者分離の結果を時刻で突き合わせて発言の列を作り、LLM で要約と、決定事項とタスクの抽出を別々に行います(6 の深掘り)。
- 修正画面と共有:主催者は要約とタスクを、根拠の発言と並べて確かめて直し、直したものを共有します。共有先への送り出しはキューを通して非同期に行います。
録音の通知は取り込み元ごとに持たせます。スマホアプリは録音を始めるときに画面と音で知らせ、オンライン会議は会議ツールの録音機能が出す通知を使います。会議にボットを参加させる場合は、ボットが参加したこと自体が通知になります。
実例:Zoom は録音がダウンロードできるようになるたびに
recording.completedの通知を送り、ダウンロード用の URL とトークンを渡します(Zoom Developer Blog)。Teams は、会議が終わって録音や文字起こしができたときに変更通知を送る仕組みを持ち、取り出すには組織全体の権限を管理者が認めるか、会議ごとの権限を使います(Microsoft Learn)。音声認識の API を提供する Gladia は、議事録ツールの既定を会議後に録音全体を処理する方式にし、ジョブを投げて完了の通知を受けてから LLM の処理を始める流れを勧めています(Gladia, 2026)。
代わりの案:Teams が会議後に作る文字起こしをそのまま取り込めば、ASR の費用と時間を省けます。ただし対面の会議には使えず、顧客の管理者がこの取り出しを止めている場合や、話者の情報を出さない設定にしている場合もあります。用語辞書も使えません。そのため、使える顧客では選べる取り込み元の 1 つにとどめ、標準は自前の ASR にします。
5. 深掘り:音声処理の流れ
録音は無音の位置でチャンクに区切って ASR を並列に進め、話者分離は録音全体で 1 回だけ行います。対面の会議は会議中からチャンクで受け取り、届いたそばから処理しておきます。最初の仮説の 1 は、ここで崩れます。
答えの段階 | 答え | 足りないところ |
|---|---|---|
弱い答え | 録音を ASR と話者分離に通して、LLM で要約します | 3 時間の会議を 10 分で処理する方法が無い |
よい答え | 録音を区切って ASR を並列に進めます | 境目で語が切れることと、チャンクをまたいで話者がずれることに答えていない |
より良い答え | 無音の位置で区切ってキューとワーカーで並列に処理し、話者分離は録音全体で行って時刻で突き合わせます | なし(中身は下の 6 つ) |
より良い答えの中身は次のとおりです。
- 無音の位置で区切る:VAD(録音のうち人が話している区間と無音の区間を見分ける処理)で無音の区間を見つけ、数分を目安に、話の途中ではなく無音のところで区切ります。発言の途中で切ると、境目の語が両方のチャンクで崩れます。話し続けて無音が来ない区間だけは決めた長さで切り、前後を数秒重ねて、重なった部分の文字は時刻を見て片方だけ残します。
- 無音を送らない:VAD で見つけた無音の区間は ASR に送りません。ASR は音声の長さで課金されるので、そのぶん費用が下がります。
- 話者分離は録音全体で 1 回:チャンクごとに話者分離をすると、チャンク 1 の「話者 A」とチャンク 2 の「話者 A」が同じ人か分かりません。ASR はチャンクごとに並列に進め、話者分離は録音全体に 1 回かけ、最後に語の時刻と話者の時間帯を突き合わせて発言に話者を付けます。話者数の上限は参加者の最大 20 名で渡せます。録音全体に 1 回かけても時間はかからず、pyannote.audio の README では GPU(NVIDIA H100)で音声 1 時間あたり約 31 秒なので、3 時間で 2 分弱です。
- ジョブはチャンク単位で、やり直しても結果は同じ:ジョブは会議 ID とチャンクの連番で決まり、結果もその組で保存します。同じジョブが 2 回届いても、結果があれば ASR を呼ばずに終えます。失敗したチャンクだけを再試行するので、3 時間の会議でも最初からやり直すことはありません。
- 締め切りの近い順に処理する:10〜11 時と 14〜16 時には会議の終了も集中します。キューは終了時刻の早い会議のチャンクから取り出し、ワーカーはキューの長さを見て増減します。会議中に届く対面のチャンクは締め切りが遠いので、後回しにできます。
- 最初に詰まるのは外部 API:ワーカーは増やせますが、外部の ASR API には同時に受け付ける数の上限があります。その上限を契約で確かめ、上限を超える分はキューで待たせます。1 年後の 20 倍に向けては、上限の引き上げか、2 社目の ASR を使えるようにしておくかを決めます。
対面の会議は、スマホアプリが会議中から数分ごとのチャンクを送るので、事前知識の「会議中から少しずつ」の方式になります。終了の時点で残る仕事は最後のチャンクの ASR、話者分離、要約だけです。電波が弱く録音後にまとめて届く場合は、終了後 10 分の起点をアップロードが終わった時点と置き、その旨を主催者の画面にも出します(前提に無いので仮定です)。
実例:WhisperX は、VAD で録音を発話のまとまりに区切ってから ASR をまとめて並列に流すことで、長い録音の文字起こしを約 12 倍速くし、精度も上げたと報告しています。区切らずに長い録音を流すと、ずれや繰り返しが起きやすいことも挙げています(WhisperX, 2023)。OpenAI の文字起こし API は 1 ファイル 25 MB までで、長い録音は分割するように、その際は文の途中で切ると精度が下がるので避けるように書いています(OpenAI)。
6. 深掘り:取りこぼさない要約
文字起こしは話題の区切りで分けて要約し、決定事項とタスクと担当者と期日は、要約の文章とは別に、決まった形式で取り出します。最初の仮説の 2 は、ここで崩れます。
答えの段階 | 答え | 足りないところ |
|---|---|---|
弱い答え | 文字起こし全体を LLM に渡して要約させます | 長い入力の中ほどにある決定やタスクが抜けやすい |
よい答え | 区切って要約し、最後にまとめます | 決定事項やタスクを、要約の文章の中から主催者が探すことになる |
より良い答え | 区切って要約し、決定事項とタスクは別の形式で取り出して、根拠の発言に結び付けます | なし(中身は下の 5 つ) |
- 話題の区切りで分け、前後を重ねる:長さだけで機械的に分けず、話題の変わり目で分けます。分けた区間には直前の区間の終わりを少し重ねて渡し、「さっきの件は来週までに」のような前を受けた発言が何を指すかを分かるようにします。
- 区間ごとと全体の 2 回で処理する:区間ごとに要点と、決定事項とタスクの候補を出し、最後に全体を見て重複をまとめます。同じタスクの期日が途中で変わったら、後の発言を採ります。
- 決まった形式で取り出す:決定事項とタスクは、本文、担当者、期日、根拠の発言 ID を持つ形式で出させ、形式に合わない出力は捨ててやり直します。明示された約束だけを取り、「誰かがやるだろう」のような推測のタスクは作らせません。
- 担当者と期日を確かめる:担当者は会議の参加者の名前と突き合わせ、合わなければ印を付けます。期日は「来週の金曜」のような言い方を会議の日付から日付に直し、元の言い方も残します。社名は用語辞書と突き合わせます。この 3 項目の誤りが問題になるので、印の付いた項目を修正画面の先頭に出します。
- 根拠の発言に戻れるようにする:各項目は根拠の発言 ID を持つので、主催者は項目を押すとその発言と録音の該当箇所を確かめられます。録音全体を聞き直さずに済むので、修正の時間が短くなります。
要約は ASR がすべて終わってから始めると、その分だけ待ち時間が延びます。区間ごとの要約は、その区間の発言がそろった時点で始められるので、対面の会議のように会議中にチャンクが届く場合は、区間ごとの要約まで会議中に済ませておけます。最後の全体のまとめだけを終了後に行います。
実例:言語モデルは、入力の最初か最後にある情報はよく使えるが、長い入力の中ほどにある情報を使う性能は大きく下がるという報告があります(Lost in the Middle, 2023)。3 時間の文字起こしを 1 回で渡さない理由の 1 つです。Gladia は、議事録の要約やタスクを LLM に出させるときは出力を決まった形式に縛り、担当がはっきりした明示の約束だけを取り出すよう指示する例を示しています(Gladia, 2026)。
7. 深掘り:認識誤りの補い方
顧客ごとの用語辞書を、ASR に渡すヒントと、認識したあとの置き換えの 2 か所で使い、主催者が直した語を辞書に返します。最初の仮説の 3 は、ここで崩れます。
答えの段階 | 答え | 足りないところ |
|---|---|---|
弱い答え | 精度の高い ASR を選びます | 顧客の社名や製品名は、どの ASR も知らない |
よい答え | 顧客ごとの用語辞書を ASR のヒントに渡します | 5,000 語がヒントに入りきらない場合と、辞書に無い語の誤りが残る |
より良い答え | 辞書を ASR のヒントと認識後の置き換えに使い分け、主催者の修正で辞書を育てます | なし(中身は下の 4 つ) |
- ASR のヒントには絞って渡す:ASR の API が受け付けるヒントの量には上限があり、5,000 語をすべて渡せるとは限りません。会議のタイトル、参加者の所属、その顧客の過去の会議でよく出た語から、その会議に関係しそうな語を選んで渡します。
- 認識後に置き換える:ヒントに入らなかった語は、ASR の結果に対して辞書全体を使って直します。読みが近い語の置き換えは LLM に任せ、置き換えた箇所には印を残して主催者が確かめられるようにします。
- 主催者の修正を辞書に返す:ASR の結果と主催者が直した本文の差から、「ある語が決まった語に直された」組を集めます。同じ直しが何度も起きたら、その顧客の管理者に辞書への追加を提案します。勝手に足さないのは、1 人の直し方を顧客全体に広げないためです。
- 対面の話者は名前の付け替えで直す:マイク 1 本の対面の会議では、話者分離が「話者 A」「話者 B」を取り違えることがあります。主催者が「話者 A は山田さん」と 1 回指定すれば全部の発言に反映し、取り違えた発言だけは 1 件ずつ話者を変えられる画面にします。
英語が混ざる約 1 割の会議には、1 つの会議の中で言語が切り替わっても認識できる ASR を選び、辞書には英語の製品名も読みと一緒に入れられるようにします。
実例:Google Cloud の Speech-to-Text は、認識させたい語句の一覧(PhraseSet)と、その語句をどれだけ優先するかの重み(boost)を渡せます(Google Cloud)。Amazon Transcribe は、社名や製品名、略語などを登録するカスタム語彙を持ち、1 ファイル 50 KB までという上限があります(AWS)。OpenAI は、whisper-1 のヒント(prompt)は 224 トークンまでなので、長い語の一覧を使うなら認識後にテキストのモデルで直す方法を挙げています(OpenAI)。Google Cloud の話者分離は、語ごとに話者の番号を付け、想定する話者数の下限と上限を渡す作りです(Google Cloud)。
8. 障害への備えと監視
どこが止まっても、録音と途中までの結果は残り、止まったところから再開できるようにします。主催者に見えるのは要約が遅れることで、遅れるときはそのことを画面に出します。
止まるもの | 主催者に見えること | 手当て |
|---|---|---|
Zoom と Teams からの通知 | 要約が届かない | 定期的に録音の一覧を取りに行き、取り込んでいない会議を拾う。Zoom のダウンロード用トークンは 24 時間で切れるので、遅れたら API で URL を取り直す |
スマホアプリの送信 | 録音の一部が欠ける | チャンクの連番から欠けた番号を見つけ、端末に送り直させる。全部そろうまでは最後のまとめを始めない |
外部の ASR API | 要約が遅れる | キューにためて間隔を空けて再試行する。10 分を超えそうな会議は、主催者の画面に遅れを出す |
LLM | 文字起こしはあるが要約が無い | 文字起こしだけ先に見せ、要約は戻りしだい足す |
ワーカーの途中停止 | 変わらない | キューがジョブを配り直す。結果がすでにあるチャンクは ASR を呼ばずに終えるので、二重に課金されない |
監視するのは、会議の終了から要約が届くまでの時間(遅いほうの 5% を含めて)、キューの滞留、外部 API の失敗率、主催者が修正にかけた時間です。最後の数字は、修正を平均 10 分以内にする目標をそのまま測るものです。
9. 条件の変更への対応
面接の後半では、運用で起きた不具合や将来の要望という形で条件が足されます。答え方は、今の設計でなぜ起きたか、何をきっかけに何をどう処理して直すか、変えずに済むところはどこか、の順です。
例 1:削除依頼に応じたあとも、文字起こしの一部が残っていた
- 原因:録音と議事録は消したが、チャンク、ASR の結果、処理中だったジョブの出力、社内チャットに送った本文が残っていた。
- 直し方:削除依頼をきっかけに、会議 ID ごとの削除ジョブをキューに入れ、会議に結び付く保存先を順に消します。ワーカーは結果を保存する前に会議の状態を見て、削除済みなら結果を捨てます。削除ジョブも失敗したら再試行し、同じ会議を 2 回消しても結果は変わらないようにします。共有先には本文ではなく議事録へのリンクを送り、本文はこちらで消せるようにします。
- 変えずに済むところ:取り込みから要約までの流れです。すべての表が会議 ID を持っているので、消す対象はたどれます。
例 2:大口顧客から、オンライン会議の途中でも要約を見たいと求められた
- 影響:Zoom と Teams の録音は会議が終わってから取り出せるので、会議中の音声は、ボットを会議に参加させるか、会議ツールが会議中の音声をアプリへ渡す仕組み(Zoom の Realtime Media Streams など)を使って受け取ります。どちらも会議ツールごとに作りが違います。
- 直し方:その顧客の会議では、どちらかの手段で会議中の音声を受け取り、数分ごとのチャンクにして取り込みに流します。ボットを使う場合は、ボットが参加したこと自体が参加者への録音の通知になります。チャンクから先は対面の会議と同じで、区間ごとの要約を会議中に積み上げて見せます。
- 変えずに済むところ:チャンクから先の流れ、データモデル、用語辞書です。増えるのは会議ツールごとの音声の受け取りなので、要望のある大口顧客から入れます。
実例:AWS の Live Meeting Assistant は、Zoom や Teams などの会議にボットを参加させて音声を受け取り、会議中に文字起こしと要約、タスクの作成を行う構成を公開しています(AWS, 2024)。Microsoft も、会議にボットを参加させて録音していることを示すバナーを出し、録音と文字起こしを取り出すアプリの作り方を例に挙げています(Microsoft Learn)。
まとめ:選んだものと捨てたもの
判断 | 選んだ案 | 捨てた案、代わりの案 | 理由 |
|---|---|---|---|
処理のタイミング | オンライン会議は終了後に区切って並列、対面は会議中から少しずつ | 会議後に一括、リアルタイム字幕 | 3 時間の会議でも 10 分に収まり、字幕は作らない |
処理の単位 | 無音の位置で区切った数分のチャンク | 録音 1 本 | 失敗した分だけやり直せ、取り込み元が違っても同じ流れにできる |
話者分離 | 録音全体で 1 回、時刻で突き合わせる | チャンクごと | チャンクをまたいでも話者のラベルがそろう |
要約 | 区切って要約し、決定事項とタスクは別の形式で根拠つき | 全体を 1 回で要約 | 中ほどを落とさず、社名と担当者と期日を確かめられる |
用語辞書 | ASR のヒントと認識後の置き換え、修正を辞書に返す | ASR のヒントだけ | 5,000 語がヒントに入りきらない場合と、辞書に無い語に対応できる |
Teams の文字起こし | 使える顧客で選べる取り込み元の 1 つ | 代わりの案:標準にする | 対面には使えず、管理者の設定で取れないことがあり、辞書も使えない |
会議中の要約 | 後から足せる形だけ用意する | 最初から作る | オンライン会議では、会議中の音声の受け取りを会議ツールごとに作る必要がある |
よくあるつまずき
つまずき | なぜ弱いか | 抜け出す一手 |
|---|---|---|
面接の最初から構成図を話し始める | 最長 3 時間と 10 分以内の組み合わせや、取り込み元の違いを取りこぼす | 会議の長さ、待ち時間の許容、音声の入り方を先に聞く |
「録音を AI に渡すと議事録になる」で止まる | どこで時間がかかり、何が誤るかを説明できない | ASR、話者分離、要約の順に、それぞれ何をして何に時間がかかるかを言う |
区切って並列にする、とだけ言う | 境目で語が切れることと、話者がチャンクをまたいでずれることに答えていない | 無音の位置で区切り、話者分離は録音全体で行うと言う |
リアルタイム字幕の仕組みで作る | 字幕は作らない前提で、精度と費用の面で不利になる | 数分遅れてよいので、チャンク単位で処理すると言う |
要約の中にタスクも書かせる | 担当者と期日の誤りを確かめられず、主催者が文章から探すことになる | 決定事項とタスクは別の形式で取り出し、根拠の発言に結び付ける |
精度の高い ASR を選ぶ、とだけ言う | 顧客の社名や製品名はどの ASR も知らない | 用語辞書をヒントと認識後の置き換えに使い、主催者の修正を辞書に返す |
削除と保持期間を録音だけで考える | 文字起こしやチャンク、共有先の本文が残る | 会議 ID でたどれるように持ち、会議単位で消す |
▼解説を読んだら、同じお題を AI 面接官を相手に通しで解いてみましょう。
参照元
技術ブログ、公式ドキュメント、論文です。どれも開いて内容を確かめています。Gladia と AWS の記事は自社の製品の紹介を兼ねています。
節 | 記事 | 参照した内容 |
|---|---|---|
4 | Zoom Meeting API querying tips: Download recordings using webhooks(Zoom) | 録音の準備ができたときの |
4, 9 | Fetch Meeting Transcripts & Recordings(Microsoft Learn) | 会議後の録音と文字起こしの取り出し、変更通知、管理者の許可、ボットによる録音の表示 |
4, 6 | How to build an AI note-taker(Gladia, 2026) | 会議後に処理する方式を既定にする構成、明示の約束だけを取り出す指示 |
5 | WhisperX: Time-Accurate Speech Transcription of Long-Form Audio(2023) | VAD で区切ってまとめて並列に流し、約 12 倍の高速化 |
5, 7 | File transcription(OpenAI) | 25 MB の上限と文の途中で切らない分割、224 トークンのヒントと認識後の修正 |
5 | pyannote.audio(GitHub) | GPU(NVIDIA H100)で測った、音声 1 時間あたりの話者分離の処理時間 |
6 | Lost in the Middle: How Language Models Use Long Contexts(2023) | 長い入力の中ほどにある情報を使いにくい |
7 | Model adaptation(Google Cloud) | 語句の一覧と重みで特定の語を認識させやすくする |
7 | Custom vocabularies(AWS) | 社名や製品名を登録するカスタム語彙とその上限 |
7 | Speaker diarization(Google Cloud) | 語ごとの話者番号と、話者数の下限と上限の指定 |
9 | Realtime Media Streams(Zoom) | 会議中の音声、映像、文字起こしをアプリへ渡す仕組み |
9 | Live Meeting Assistant(AWS, 2024) | 会議にボットを参加させ、会議中に文字起こしと要約を作る構成 |
▼ほかのお題の解説
サカモトエンジニア監修
外資系企業のソフトウェアエンジニア。エンジニアのキャリアや面接について X や note で発信し、テック企業を目指すエンジニア向けの面接対策プラットフォーム InterviewCat を運営しています。

公式アカウント
CaseMatch編集部
CaseMatch編集部は、就活・転職における面接対策やキャリア選択に役立つ情報を発信する編集チームです。AI面接練習サービス「CaseMatch」の運営で得た知見や、企業選考・ケース面接・自己分析に関する実践的なノウハウをもとに、候補者が納得感を持って選考に臨めるコンテンツをお届けします。
面接練習で、選考を有利に進めよう。

1分で完了


