
ケース面接
2026/11/03
技術設計面接の解説と模範解答|金融ドメインにおけるOCRアプリケーション
目次
技術設計面接(システムデザイン面接)のお題「金融ドメインにおけるOCRアプリケーション」を題材に、事前に押さえておく知識、面接で引き出せる前提、論点、模範解答、よくあるつまずきを順に解説します。
ほかのお題の解説は技術設計面接の解説と模範解答まとめにあります。
より詳しい情報はこちら
この記事で使う設計の基礎は、日本語のシステムデザイン面接の教材 SystemDesign InterviewCat で詳しく学べます。この記事の各節に関係する章は次のとおりです。
InterviewCat の章 | この記事で関係する節 |
|---|---|
SystemDesign InterviewCat の全体像 | |
面接で見られることと進め方 | |
4. 全体構成(受付と画像の保存) | |
4. 全体構成、7. 個人番号の秘匿とスマホの画質 | |
3. データモデル(画像の 10 年保存) | |
4. 全体構成、5. GPU 2 枚の配分 | |
5. GPU 2 枚の配分、8. 障害への備え | |
8. 障害への備え(読み取りの再試行) |
事前知識:書類の読み取り方式と最初の仮説
設計面接では、お題を聞いた時点で「たぶんこの作りだろう」という仮説を持ち、前提を聞くたびにそれを確かめたり崩したりします。書類の画像から項目を読むお題なら、まず「画像から文字を読む処理と、どの値がどの項目かを決める処理を分けるか、1 つのモデルにまとめて任せるか」の選択肢を押さえておきます。この選び方を、この記事では読み取り方式と呼びます。
書類の画像が登録されるまでの流れ
書類の画像は、前処理のあと 2 通りの読み方のどちらかを通り、最後に人が確かめるかどうかを分けてから登録されます。
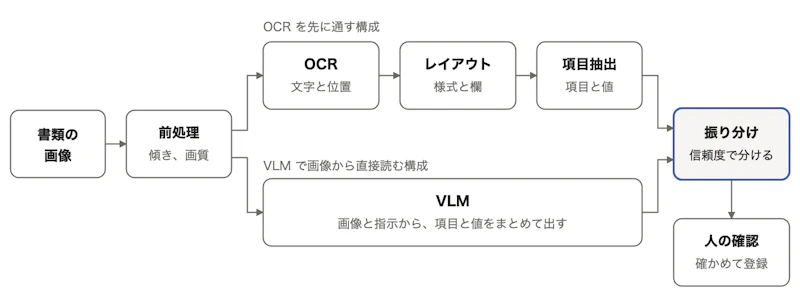
- OCR:画像の中の文字がどこにあるかを見つけ(検出)、その文字を読む(認識)処理。読んだ文字ごとに画像上の位置が出る
- レイアウト解析:ページがどの様式か、どこが表や欄かを判定する処理
- 項目抽出:読んだ文字のうち、どれが「借入額」の値でどれが「年収」の値かを決める処理
- VLM:画像と文章の両方を入力に取る大きなモデル(視覚言語モデル)。「この申込書の借入額は?」と聞くと、値を文章で返す
- 信頼度:モデルが項目ごとに出す 0 から 1 の値。高いほど正しいことが多いが、何割正しいかは自分の書類で数えるまで分からない
読み取り方式の違いは、文字を読む処理と項目を決める処理を別々の部品にするか、1 つのモデルにまとめるかの違いです。どちらを選んでも、最後に信頼度で人の確認へ振り分ける工程は残ります。
それぞれの方式で何が起きるか
申込書の手書きの借入額の欄を例に、方式ごとに裏で起きることを並べます。
様式ごとの位置指定:図の OCR の手前で、決まった位置だけを切り出す方式です。様式ごとに「借入額はこの四角の中」と位置を登録しておき、その四角を切り出して OCR で読みます。様式が決まった活字の書類なら、速く、どの値が画像のどこから来たかもはっきりします。弱いところは、登録していない様式や位置のずれに対応できないことです。古い様式や、勤務先ごとに少しずつ違う源泉徴収票では、様式ごとに登録を足し続けることになります。手書きの借入額は四角の中にあれば切り出せますが、読めるかどうかは OCR の精度しだいです。
OCR を先に通す構成(以下、OCR 構成):OCR でページ全体の文字と位置を読み、レイアウト解析で様式と欄を判定し、項目抽出で値を項目に割り当てます。項目抽出には、OCR の文字と位置から項目を選ぶ小さなモデルを、自社の書類で学習させて使います。位置指定と比べると、様式が少し違っても、「借入額」という見出しの右にある数字、のように見出しと並びから項目を決められます。部品ごとに小さいので速く、文字ごとの信頼度と位置が出るため、確認画面で画像の該当箇所を示せます。値は OCR が読んだ文字の中から選ぶので、読み誤りはあっても、書かれていない値を作り出すことはありません。弱いところは 2 つあります。1 つは、OCR の読み誤りがそのまま後ろの部品に伝わることです。手書きの「3」を OCR が「8」と読むと、項目抽出はそれを正しい借入額として扱います。もう 1 つは、VLM と比べると、様式ごとに正解を付けた書類を用意して学習させる手間が要ることです。
VLM で画像から直接読む構成:ページの画像と「申込書の項目をこの形の JSON で返して」という指示を VLM に渡し、項目と値をまとめて受け取ります。OCR 構成と比べると、文字の検出を挟まないので検出の漏れがなく、手書きの借入額や見たことのない様式でも、見出しの意味から値を探せることが多いです。弱いところは 3 つあります。1 つは重さで、ページごとに GPU で大きなモデルを動かすので、OCR 構成より 1 ページあたりの時間も GPU も多く要ります。2 つめは、文章を生成する方式なので、画像に無い値をもっともらしく書く誤り(ハルシネーション)を仕組みとして避けられないことです。3 つめは、位置を返せるモデルもありますが、その位置や信頼度が、OCR が文字ごとに出す値ほど当てにならないことです。
設計面接で比べたいのは製品やモデルの名前ではなく、どのページをどちらの読み方に通し、どの項目を人に見せるかです。
方式を比べる
方式の違いは、活字の申込書、手書きの借入額の欄、様式が少しずつ違う書類の 3 つの場面に、重さと「確認画面で根拠を示せるか」を加えて比べると分かりやすくなります。
方式 | 店頭スキャナで取った活字の申込書 | 手書きの借入額の欄 | 勤務先ごとに様式が違う源泉徴収票 | 1 ページの重さ | 値が画像のどこから来たかを示せるか |
|---|---|---|---|---|---|
様式ごとの位置指定 | 速く正確に読める | OCR の精度しだいで誤りやすい | 様式ごとの登録が要る | 軽い | 示せる |
OCR 構成 | 速く正確に読める | 読み誤りが項目抽出へそのまま伝わる | 見出しと並びから読めることが多い | 軽い | 示せる |
VLM | 読めるが、OCR 構成より遅い | OCR 構成より読めることが多い | 読めることが多い | 重い(GPU が要る) | 位置を返せるが、正しいとは限らない |
表から分かるとおり、位置指定と OCR 構成は速く根拠も示せますが手書きに弱く、VLM は手書きや様式の違いに強い代わりに GPU を多く使い、根拠も当てにしにくくなります。どちらか 1 つを全ページに使う必要はありません。OCR 構成で全ページを読み、読めなかったところだけを VLM に回す組み合わせが取れます。今回のお題では、GPU が 2 枚しかないので、この組み合わせ方が設計の中心になります。
どちらの読み方でも、最後に信頼度で人の確認へ回すかを決めます。決まった値(閾値)より低い項目だけを回し、重要項目は値によらず回します。
最初の仮説
お題文だけを読んだ段階では、次の仮説を置きがちです。どれも筋は悪くありませんが、前提を聞くと一部が崩れます。答え合わせは「隠れていた前提を見直す」で行います。
仮説 | 中身 | 確かめること |
|---|---|---|
1 | 今は大きな VLM が一番よく読めるので、全ページをそれで読めばよい | GPU の数、1 日のページ数、受付が集中する時間帯 |
2 | クラウドの OCR サービスか LLM の API を呼べば済む | 外へ出せるデータ、行内ネットワークの制約 |
3 | 読み取った全項目を、最後に人が確認すればよい | 1 件にかけてよい時間、読む項目の数、誤りを許さない項目 |
4 | 個人番号は、読み取りが終わってから伏せればよい | 個人番号を取得してよいか、画像をどこにいつ保存するか |
お題と要件
面接官から示されるお題は次のとおりです。
本日はシステムの設計方法についてディスカッションしたいと思います。今、銀行のローン申込書の入力作業をなくすために、OCRのアプリを作ることを考えています。申込書・本人確認書類・源泉徴収票の画像から項目を読み取り、事務担当者が確認・修正してから登録できるようにしたいです
▼このお題は CaseMatch の AI 面接で、面接官に前提を質問しながら練習できます。
前提は質問すれば答えてもらえます。面接で引き出せる前提を、読み取り方式の選び方に関わるものとそれ以外に分けて並べます。種類の列は、機能要件、非機能要件、制約、将来の変更のどれにあたるかです。設計への影響の列は、次の節の問いを考えてから読んでください。
読み取り方式の選び方に関わる前提
事前知識の比較表の場面(活字、手書き、様式の違い)と、VLM に使える GPU の量、外のサービスを使えるかを決める前提です。
種類 | 前提 | 値 | 設計への影響 |
|---|---|---|---|
非機能 | 処理量 | 1日300件、1件10〜20ページ | 1 日最大約 6,000 ページを読む |
非機能 | 受付の山 | 受付は9〜15時に集中し、審査部門への締めは17時 | GPU の量は受付が集中する時間で見積もる |
非機能 | 確認画面に出るまで | 1件(10〜20ページ)は、受付から30分以内に確認画面に出ていればよい | その場で返さず、キューで待たせてよい |
機能 | 受付経路 | 受付経路は店頭スキャナ7割、郵送2割、スマホからのアップロード1割 | 画質の悪い入力は今は 1 割にとどまる |
制約 | 画質 | 店頭スキャナは300dpi、スマホの写真は解像度も傾きもばらばら | スマホの写真には前処理と画質の判定が要る |
機能 | 様式 | 7種類の様式と古い様式が届く | 様式ごとの位置指定だけには頼れない |
非機能 | 手書き | 4割が手書き | OCR 構成だけでは読み切れない |
機能 | 源泉徴収票 | 源泉徴収票は勤務先ごとに様式が少しずつ違う | 様式によらずに項目を決める部品が要る |
制約 | GPU | 行内のデータセンターに、すぐ使えるGPUが2枚ある。追加の調達には半年かかる | VLM に回す範囲を絞る |
制約 | ネットワーク | 行内ネットワークはインターネットにつながらない | モデルはすべて行内で動かす |
制約 | OSS の導入 | OSSの導入には1か月のセキュリティ審査が要る | 使う OSS の部品を少なく選ぶ |
制約 | 外部の LLM | 個人情報を外部商用LLM APIへ送らない | VLM も行内の GPU で動かす |
制約 | 予算 | 初年度の開発と運用の費用は3,000万円以内。GPUを買い足す場合は来年度の予算になる | 初年度は GPU 2 枚で回す |
将来 | スマホの割合 | スマホからのアップロードを5割まで増やしたい | VLM に回るページが増える |
将来 | 方針の変更 | 個人情報を伏せれば外部のLLMを使ってよい、と方針が変わる可能性がある | VLM の置き場所を差し替えられるようにする |
それ以外の前提
確認の手間、誤りの扱い、個人番号、保存、止まったときの扱いのように、どの読み取り方式を選んでも別に設計が要る前提です。
種類 | 前提 | 値 | 設計への影響 |
|---|---|---|---|
機能 | 目標 | 今は手入力とダブルチェックで1件約20分かかる。これを確認と修正だけの1件5分にしたい | 全項目は確認できない |
非機能 | 誤りの見つけ方 | 重要項目の読み取り誤りは、確認の段階で必ず見つけられる必要がある | 重要項目は信頼度によらず確認に回す |
非機能 | 当日中 | 受付当日中に審査へ | 確認待ちを夕方に溜めない |
機能 | 読む項目 | 申込書から読む項目は約40で、重要項目は金利・借入額・返済期間・年収・口座番号 | 項目ごとに確認の扱いを分ける |
制約 | 個人番号 | マイナンバーカードの個人番号は取得してはならず、画像でも隠す必要がある | 保存の前に画像から隠す |
機能 | 今の運用 | 今は事務担当者が1件約20分で手入力し、別の担当者がダブルチェックしている | 止まったときの戻り先になる |
非機能 | 重要項目 | 金利・借入額など重要項目は誤りを許さない | 信頼度が高くても自動では通さない |
非機能 | 止まったとき | 停止時は手入力に戻せる | 画像と処理の状態を見れば手入力に切り替えられるようにする |
機能 | 保存と記録 | 書類の画像は10年保存し、誰がどの項目を修正したかも記録する | 修正の記録は追記のみで持つ |
機能 | 確認する人 | 確認と修正を行う事務担当者は20名 | 確認待ちの件を担当者に配る仕組みが要る |
制約 | 審査 | 審査の判断そのものは自動化しない | 作る範囲は登録まで |
将来 | 展開 | 最初の半年は本店の1部署で試し、1年後に全支店で使い始める | 試行の間に振り分けの閾値を決める |
隠れていた前提を見直す
お題文は「画像から項目を読み取り、事務担当者が確認してから登録する」としか言っていません。前提の表は、質問して初めて出てきたものです。設計への影響を見る前に、あらためて前提を読み直し、お題文の裏に何が隠れていたかを考えます。先に次の問いを考えてから、前提の表の「設計への影響」の列と見比べてください。
- 前提のうち、互いにぶつかっている 2 つの組を 3 組挙げてください。
- VLM を使いたい理由と、使う範囲を絞りたい理由を、前提から 1 つずつ挙げてください。
- 最初の仮説 1〜4 のうち、どれがどの前提で崩れますか。
- お題文からは読み取れなかったのに、設計を一番大きく変えた前提はどれですか。
前提どうしのぶつかり
前提の多くは単独では難しくありません。難しいのは 2 つが互いに逆を向いているところで、このお題では次の 3 組です。これがそのまま、面接の後半で詳しく問われる 3 つの論点(深掘り)になります。
ぶつかる前提 | なぜぶつかるか | 解き方 |
|---|---|---|
4 割が手書き × GPU は 2 枚で調達に半年 | 手書きを読むには VLM を使いたいが、全ページに使うと受付が集中する時間に GPU が足りない | 全ページを OCR 構成で読み、手書きの欄と信頼度の低いページだけを VLM に回す |
重要項目の誤りを必ず見つける × 1 件 5 分 | 誤りを確実に見つけるには全項目を見たいが、約 40 項目と 10〜20 ページを見ると 5 分に収まらない | 重要項目は信頼度によらず必ず、それ以外は信頼度の低い項目だけを画像と並べて見せる |
個人番号を取得しない × 画像を 10 年保存、スマホの写真はばらばら | 画像をそのまま保存すると個人番号も 10 年残り、ぼやけた写真では番号の欄を見つけられず隠し漏れる | 受付で画質を判定し、保存の前に番号の欄を塗りつぶし、塗れなかった画像は保存しない |
仮説の答え合わせ
仮説 | 崩した前提 | 置き換え |
|---|---|---|
1. 全ページを大きなモデルで読む | GPU 2 枚、1 日最大約 6,000 ページ、受付の集中 | VLM は使うが、範囲を手書きの欄と信頼度の低いページに絞る。全ページは OCR 構成で読む |
2. 外部の API を呼ぶ | インターネットにつながらない、個人情報を外部商用 LLM API へ送らない | OCR 構成も VLM も行内で動かす。方針が変わったときに置き場所を差し替えられるようにだけしておく |
3. 全項目を人が確認 | 1 件 5 分、約 40 項目 | 人が見る項目を、重要項目と信頼度の低い項目に絞る。重要項目だけは信頼度によらず見る |
4. 読み取りのあとで伏せる | 個人番号は取得してはならず、画像でも隠す | 読み取りより前、保存より前に画像から塗りつぶす。番号を文字として読む工程も通さない |
このお題は OCR の精度を上げる話に見えます。しかし実際に問われるのは、GPU 2 枚と 1 件 5 分という限られた資源の中で、VLM と人の目をどのページとどの項目に使うかを決める設計です。
解説:このお題の論点
論点は 3 つあり、重さの順に GPU 2 枚の配分、人の確認、個人番号の秘匿とスマホの画質です。どれも前提のうち 2 つが互いにぶつかっており、どちらをどう守るかを自分で決めて説明できるかが問われます。
模範解答の深掘り(5〜7)では、論点ごとに「弱い答え」「よい答え」「より良い答え」を並べ、何が足りないかを示しています。
模範解答
面接での問答の順には合わせず、このお題への答えを 1 つの設計としてまとめた解答例です。設計の筋は、受付の時点で画質を確かめて個人番号を塗りつぶし、全ページを OCR 構成で読み、手書きと自信の無いところだけを GPU で動かす VLM に回し、人には重要項目と信頼度の低い項目だけを画像と並べて見せる、というものです。前提に無いことは仮定として置き、その旨を書いています。
1. 作る範囲
前提を確かめたうえで、最初に作る範囲を次のように切ります。
- 作る:受付時の画質の判定と撮り直しの案内、個人番号の塗りつぶし、画像の 10 年保存、OCR 構成と VLM による読み取り、確認画面、修正の記録、既存の融資のシステムへの登録
- 作らない:審査の判断、店頭スキャナや郵送の受付業務そのもの、外部の LLM との連携(方針が変わるまで)、読み取りモデルの一からの学習
登録先は既存の融資のシステムで、登録の API はあると仮定します。設計の要は、GPU 2 枚を全ページに使わず、OCR 構成で読めなかったところにだけ使うことです。
2. 見積もり
見積もりで出すのは、構成を決める 3 つの数字だけです。どれも前提の値から計算できます。
見積もり | 計算 | 決まること |
|---|---|---|
受付の山の処理量 | 300 件 × 20 ページ = 6,000 ページを 9〜15 時の 6 時間で読むと、1 時間 1,000 ページ | GPU 2 枚なら、1 枚が 1 ページに使えるのは約 7 秒しかない |
手書きだけ回す場合 | 6,000 ページ × 4 割 = 2,400 ページなら、1 枚が 1 ページに約 18 秒使える | VLM に回すのは、手書きと読めなかったところに絞る |
1 件の確認 | 5 分 = 300 秒で、約 40 項目と 10〜20 ページを見る | ページをめくって探す時間は無いので、見せる項目を絞り、値の横に画像の該当箇所を出す |
1 ページの処理時間は GPU とモデルで桁が変わるので、面接では確かめたい点として聞きます。受付から確認画面に出るまでは 30 分あるので、読み取りはその場で返さず、キューで待たせてよいことになります。
3. データモデル
画像は塗りつぶし済みのものだけを持ち、読み取った値には信頼度と画像上の位置と読んだ構成を添え、人の修正は書き換えずに追記します。中心になる表は次の 4 つです。
表 | 主な項目 | 書き換え |
|---|---|---|
申込 | 申込 ID、受付経路、受付日時、状態(読み取り中、確認待ち、登録済み、手入力) | 状態だけを更新する |
ページ | ページ ID、申込 ID、書類の種類と様式、塗りつぶし済み画像の保存先、画質の判定結果 | しない |
読み取り結果 | ページ ID、項目、値、信頼度、画像上の位置、読んだ構成(OCR 構成か VLM か) | 読み直したときは行を足す |
修正の記録 | 申込 ID、項目、修正前と修正後の値、修正した担当者、日時 | 追記のみ |
画像はオブジェクトストレージに置き、10 年は消せない設定にします。読み取り結果に「読んだ構成」を持たせておくと、どちらの構成がどの様式で誤ったかを後から数えられ、振り分けの閾値を直す材料になります。
4. 全体構成
受付から確認画面までは、すべてキューでつないだ非同期の処理です。人が待つのは確認画面だけで、読み取りが遅れても受付は止まりません。
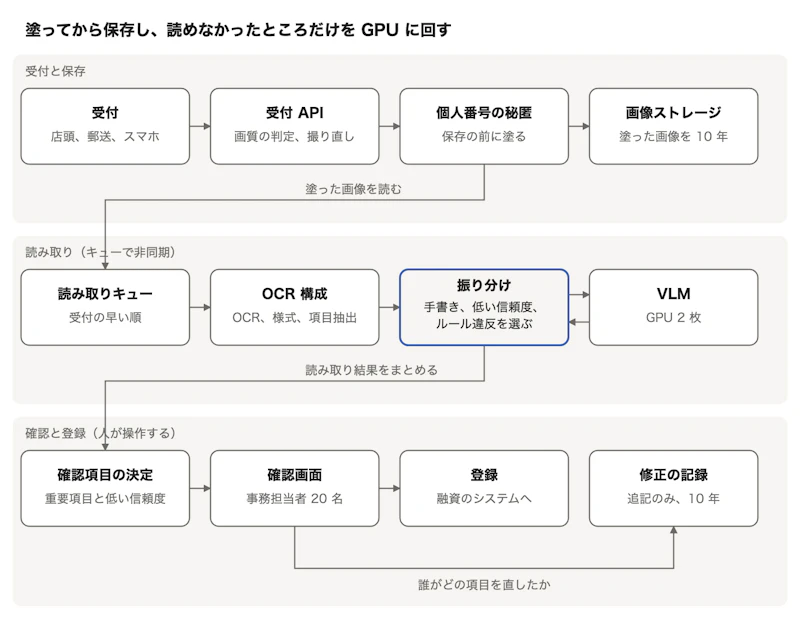
色を付けた振り分けがこの設計の要で、GPU に何を回すかと、人に何を見せるかの材料はここで決まります。
- 受付と受付 API:店頭スキャナと郵送のスキャンは店舗や事務センターから、スマホの写真は申込者のアップロードで届きます。受付 API は画質(ぼけ、傾き、暗さ、書類の四隅が写っているか)を判定し、スマホならその場で撮り直しを促します。
- 個人番号の秘匿:書類の種類を判定し、マイナンバーカードの個人番号の欄を画素ごと塗りつぶします。塗りつぶす前の画像はメモリの上だけに置き、ストレージにもキューにも渡しません。
- 画像ストレージ:塗りつぶし済みの画像だけを、10 年は消せない設定のオブジェクトストレージに置きます。
- 読み取りキューと OCR 構成:受付の早い順に、全ページを OCR 構成(OCR、様式の判定、項目抽出)で読みます。GPU を使わずに動かせる部品を選べれば、GPU 2 枚を VLM のために残せます。たとえば PaddleOCR は Apache 2.0 で公開され、日本語の文字の検出と認識、レイアウト解析を持ち、CPU でも動きます(PaddleOCR)。
- 振り分けと VLM:手書きと判定した欄、信頼度が閾値より低い項目、検証ルールに反した項目だけを、行内の GPU で動かす VLM に回して読み直します。
- 確認項目の決定と確認画面:重要項目と、読み直しても信頼度が低い項目を確認項目にし、空いている事務担当者に件を配ります。担当者は画像の該当箇所と値を並べて確かめ、直してから登録します。
- 修正の記録:誰がどの項目をどう直したかを追記のみで残し、10 年保存します。
VLM は、OpenAI 互換の API で画像を受け取れる推論サーバー(vLLM など)で行内に立てます。呼び出し側は API の形だけに依存させておくと、将来モデルを替えたり、方針が変わって置き場所を外に移したりしても、振り分けから先を変えずに済みます。
実例:Uber は請求書の処理を、OCR で文字を読んだあと LLM で項目を抜き出し、業務ルールの検証を経て人の確認に回す構成にしています。確認画面は元の PDF と抜き出した値を横に並べ、目の動きだけで見比べられる作りにして、1 件あたりの処理時間を 70% 減らしました(Uber, 2025)。Sansan は、文字の検出と認識を重ねる構成と、画像と質問から直接答えを出す自社のモデル(Viola)を比べ、後者は文字の検出漏れが起きない一方で、細かい文字に弱く、ハルシネーションは仕組みとして避けられないとまとめています(Sansan, 2024)。
代わりの案:全ページを VLM で読み、OCR 構成を持たない案もあります。部品が減るので、OSS の審査も保守も軽くなります。GPU が足りる規模なら有力ですが、今回は 1 枚が 1 ページに使えるのが約 7 秒しかなく、モデルによっては受付が集中する時間に間に合いません。値が画像のどこから来たかも当てにしにくくなります。GPU を買い足せる来年度以降に、VLM の範囲を広げる道として残しておきます。
5. 深掘り:GPU 2 枚の配分
全ページを OCR 構成で読み、VLM に回すのは手書きの欄と、OCR 構成が自信を持てなかったところだけにします。最初の仮説の 1 は、ここで崩れます。VLM を使う点は残し、使う範囲を見積もりから決めます。
答えの段階 | 答え | 足りないところ |
|---|---|---|
弱い答え | 大きな VLM で全ページを読みます | GPU 2 枚で 1 日最大約 6,000 ページが受付の集中する時間に回るかを確かめていない |
よい答え | OCR 構成で全ページを読みます | 4 割ある手書きで読み誤りが増え、確認の手間が 5 分に収まらない |
より良い答え | 全ページを OCR 構成で読み、手書きの欄と信頼度の低いところだけを VLM に回します | なし(中身は下の 5 つ) |
より良い答えの中身は次のとおりです。
- 回す条件を決める:VLM に回すのは、手書きと判定した欄、信頼度が閾値より低い項目、様式を判定できなかったページ(古い様式や見たことのない源泉徴収票)、検証ルールに反した項目の 4 つです。検証ルールには、申込書の年収と源泉徴収票の支払金額が大きく違う、日付があり得ない、のような書類をまたいだ突き合わせも含めます。
- ページではなく欄で回す:手書きは申込書の一部の欄に偏るので、ページ全体ではなく欄の切り抜きと、その欄で答える項目だけを渡します。モデルが読む画像が小さくなり、1 回の処理も軽くなります。
- 2 つの読みを比べる:VLM で読み直した値が OCR 構成の値と一致すれば、その項目の確からしさは上がります。食い違ったら、両方の値を確認画面に出して人に選ばせます。VLM のハルシネーションを、OCR 構成の読みで見つける仕組みにもなります。
- 受付の早い順に処理する:キューは件の受付時刻の順に並べ、30 分を過ぎそうな件を先に処理します。GPU の空きを待つ件が増えたら、閾値を下げて回す範囲を狭めます。
- GPU が足りないとき:VLM に回せなかった項目は、信頼度が低いまま確認に回します。人の手間は増えますが、止まりはしません。手書きの割合やスマホの写真が増えて足りなくなったら、より小さいモデルに替えるか、来年度の予算で GPU を買い足します。
この構成で最初に詰まるのは、受付が集中する昼前後の GPU です。手書きの欄が多い件が重なると VLM の待ちが伸びるので、キューの長さと、受付から確認画面に出るまでの時間を監視します。どの大きさのモデルが 1 枚の GPU に載るかは GPU の種類しだいなので、面接では確かめたい点として挙げます。
実例:Donut の論文は、OCR を先に通す構成の弱点として、OCR の計算の重さ、言語や書類の種類への柔軟さの無さ、OCR の誤りが後ろの処理へ伝わることを挙げています(Kim ほか, 2021)。行内で動かせる VLM には、請求書や帳票を構造化して出力でき、座標も JSON で返せて、3B、7B、72B の大きさで公開されている Qwen2.5-VL があります(Qwen, 2025)。
6. 深掘り:人の確認
人に見せる項目は、重要項目(金利、借入額、返済期間、年収、口座番号)は信頼度によらず必ず、それ以外は信頼度の低い項目と検証ルールに反した項目だけにします。見せ方は、書類の画像の該当箇所と値を並べる形にします。
答えの段階 | 答え | 足りないところ |
|---|---|---|
弱い答え | 最後に人が確認します | 何を確認するかが無く、全項目を見ると 1 件 5 分に収まらない |
よい答え | 信頼度の低い項目だけを確認に回します | 信頼度が高いまま誤った重要項目が確認をすり抜け、誤りを許さない前提に合わない |
より良い答え | 重要項目は必ず、それ以外は信頼度の低い項目だけを、画像の該当箇所と並べて見せます | なし(中身は下の 5 つ) |
- 重要項目は必ず見せる:信頼度は高くても誤ることがあります。誤りを許さない 5 項目は、信頼度が高くても確認画面に出し、担当者が確かめた印が無いと登録できないようにします。
- 根拠を並べる:値の横に、その値を読んだ画像の切り抜きを出します。OCR 構成が出した位置を使い、担当者が書類のページをめくって探さずに済むようにします。
- 自信の無いところを目立たせる:信頼度の低い項目、2 つの読みが食い違った項目、検証ルールに反した項目は色を変えて先頭に並べます。食い違ったときは両方の値を候補として出します。
- 閾値を試行で決める:最初の半年の試行では、確認で直された項目とその信頼度を記録し、どの閾値なら見落としが出ないかを数えます。信頼度が高くて確認に回らなかった項目も、一部を無作為に選んで人に見せ、見えないところの誤りの割合を測ります。
- 件を配る:確認待ちの件を受付の早い順に、空いている担当者へ 1 件ずつ配ります。同じ件を 2 人が同時に開かないよう、配った件には担当者を記録します。
今の運用にあるダブルチェックは、重要項目に限って残すかを確かめます。画像と並べて 1 人が確かめる形で見落としが出ないと試行で分かれば、1 件 5 分の目標に近づきます。修正したときは、誰がどの項目を何から何に直したかを修正の記録に追記します。
実例:Azure の Document Intelligence は、項目ごとの信頼度を 0 から 1 で返し、自社の値について、0.95 なら 20 回に 19 回は正しい見込みだと説明しています。正確さが重い場面では、信頼度で自動で受け入れるか人の確認に回すかを決めるよう勧め、金融や医療の記録のような場面では、学習時の正確さを 100% 近くまで上げ、人の確認を足すよう勧めています(Microsoft Learn)。Amazon Textract と組み合わせる Amazon A2I は、人の確認を始める条件として、決めた項目の信頼度、決めた項目が見つからないとき、信頼度が範囲に入るすべての項目、無作為の抜き取りを選べます(AWS)。
7. 深掘り:個人番号の秘匿とスマホの画質
受付で画質を判定し、保存の前に個人番号の欄を画素ごと塗りつぶし、塗れなかった画像は保存しません。最初の仮説の 4 は、ここで崩れます。
答えの段階 | 答え | 足りないところ |
|---|---|---|
弱い答え | 個人番号はマスクします | いつ、どこで隠すかが無い |
よい答え | 読み取りのあとに個人番号の欄を伏せて保存し直します | 読み取るまでの間、隠していない画像がストレージやキューに残る |
より良い答え | 受付で画質を確かめ、保存の前に塗りつぶし、塗れない画像は撮り直してもらいます | なし(中身は下の 5 つ) |
- 保存の前に塗る:受付 API が画像を受け取ったら、書類の種類を判定し、マイナンバーカードの個人番号が載っている面なら番号の欄を塗りつぶしてから保存します。塗りつぶす前の画像はメモリの上だけに置き、ストレージ、キュー、ログのどこにも書きません。
- 番号を読まずに塗る:カードの様式は決まっているので、カードの四隅を見つけて傾きを直し、決まった位置を塗ります。番号を OCR で文字として読む工程を通すと、読んだ結果が別の場所に残るおそれがあるので通しません。念のため、塗った位置の画素が一色になっているかと、カードの四隅から求めた位置とずれていないかを確かめます。
- 画素を書き換える:PDF の注釈のように黒い四角を上に重ねるだけでは、下に元の画像が残ることがあります。塗った画素そのものを書き換えた画像を保存します。
- 塗れないものは保存しない:カードの四隅が見つからない、ぼけて番号の欄が判定できない画像は保存せず、スマホならその場で撮り直しを促し、店頭ならスキャンし直してもらいます。
- 受付で画質を判定する:スマホの写真は、ぼけ、傾き、暗さ、反射、書類の四隅が写っているかをアップロードの時点で判定し、悪ければその場で撮り直しを促します。後の工程で読めないと分かってからでは、申込者に連絡し直すことになり、受付当日中に審査へ渡せません。
塗りつぶしたあとの画像でも、氏名、住所、生年月日など本人確認に要る欄は読めるので、読み取りと確認には影響しません。
実例:Google Cloud の Sensitive Data Protection は、画像の中の文字を OCR で見つけ、決めた種類の個人情報に当たる箇所を不透明な四角で覆った画像を返します(Google Cloud)。今回は行内で動かす必要があり、番号を文字として読む工程も避けたいので、同じ考え方を位置で塗る形に置き換えています。Dropbox は、スマホで撮った書類の写真は、しわや曲がり、影やむらのある明るさ、ぼけ、反射があってスキャナよりはるかに扱いにくいと書き、写真の向きを判定する仕組みを OCR の前に足しています(Dropbox, 2017)。
8. 障害への備えと監視
どこが止まっても、受け付けた画像は失わず、最後は手入力に戻せるようにします。例外は個人番号の秘匿で、ここが止まったら画像を保存せず受付を止めます。
止まるもの | 事務担当者に見えること | 手当て |
|---|---|---|
VLM(GPU) | 確認する項目が増える | 読み直さずに、信頼度の低いまま確認へ回す |
OCR 構成 | 確認画面に件が出てこない | キューに残して再試行する。30 分を超えた件は、画像を見ながらの手入力に切り替える |
個人番号の秘匿 | 受付ができない | 塗っていない画像を保存しないために受付を止め、紙を預かって手入力に戻す |
確認画面や登録先 | 確認や登録ができない | 読み取り結果は残るので、戻ったら続きから確認する。締めに間に合わなければ手入力に戻す |
読み取りは、同じページを 2 回読んでも結果を行として足すだけなので、再試行しても困りません。監視するのは、受付から確認画面に出るまでの時間、キューの長さ、VLM に回したページの割合、確認で直された項目の割合(項目別、様式別)、塗りつぶしに失敗して受付に戻した数です。
9. 条件の変更への対応
面接の後半では、運用で起きた不具合や将来の要望という形で条件が足されます。答え方は、今の設計でなぜ起きたか、何をきっかけに何をどう処理して直すか、変えずに済むところはどこか、の順です。
例 1:スマホからのアップロードを増やしたら、昼に 30 分を超える件が出た
- 原因:スマホの写真は OCR 構成の信頼度が下がりやすく、VLM に回るページが増えて、受付が集中する時間に GPU の待ちが伸びた。
- 直し方:受付の画質判定を厳しくし、読みにくい写真はその場で撮り直してもらいます。VLM にはページではなく欄で渡し、受付の古い件から処理します。それでも 30 分を超えそうな件は、読み直しを省いて信頼度の低いまま確認へ回します。スマホが 5 割まで増える見込みなら、来年度の予算で GPU の買い足しを決めます。
- 変えずに済むところ:個人番号の秘匿、確認画面、修正の記録、保存です。
例 2:個人情報を伏せれば外部の LLM を使ってよい、と方針が変わった
- 影響:VLM を外部の LLM に置けば GPU 2 枚の制約は緩みますが、行内ネットワークはインターネットにつながらないので、外へ出る経路を作る必要があります。
- 直し方:外へ送るのは、手書きの欄のうち、氏名や住所のような個人を特定できる欄を除いた切り抜きだけにします。何を伏せれば「伏せた」と言えるかは、どの欄を送るかの一覧として決め、送る前に塗りつぶしを確かめます。VLM の呼び出しは API の形だけに依存させてあるので、置き場所を替えるだけで済みます。
- 変えずに済むところ:振り分けの条件、確認画面、修正の記録です。
まとめ:選んだものと捨てたもの
判断 | 選んだ案 | 捨てた案、代わりの案 | 理由 |
|---|---|---|---|
読み取り方式 | 全ページを OCR 構成、手書きと自信の無いところだけ VLM | 全ページを VLM、OCR 構成だけ | GPU 2 枚で受付の山に間に合い、手書き 4 割も読める |
モデルの置き場所 | 行内の GPU で動かす | 外部の OCR や LLM の API | インターネットにつながらず、個人情報を外へ送れない |
VLM に渡す単位 | 欄の切り抜き | ページ全体 | 手書きは一部の欄に偏り、渡す画像を小さくできる |
人の確認 | 重要項目は必ず、それ以外は信頼度の低い項目だけ | 全項目、信頼度の低い項目だけ | 1 件 5 分に収め、重要項目の誤りを見落とさない |
個人番号 | 受付で位置を塗ってから保存 | 読み取りのあとで伏せる | 隠していない画像をどこにも残さない |
スマホの画質 | 受付の時点で判定し撮り直しを促す | 後の工程で読めなかったら連絡する | 受付当日中に審査へ渡せる |
処理のつなぎ方 | キューでつないだ非同期 | 受付の応答の中で読む | 30 分の猶予があり、GPU の待ちで受付を止めない |
よくあるつまずき
つまずき | なぜ弱いか | 抜け出す一手 |
|---|---|---|
面接の最初から OCR の製品やモデルの名前を挙げる | GPU の数、手書きの割合、外部の API を使えるかといった、方式を決める条件を取りこぼす | 処理量、手書き、GPU、ネットワークを先に聞く |
大きなモデルで全部読むと言う | GPU 2 枚で受付の山に間に合うかを説明できない | 1 日のページ数と GPU 1 枚が 1 ページに使える時間を 1 行で計算する |
最後に人が確認する、とだけ言う | 何を確認するかが無く、全項目なら 5 分に収まらない | 重要項目と信頼度の低い項目に絞り、画像と並べると言う |
信頼度が高い項目は確認しないと言う | 信頼度が高くても誤ることがあり、重要項目の誤りを見落とす | 重要項目は信頼度によらず確認に回す |
個人番号はマスクする、とだけ言う | 隠す前の画像がどこかに残るかどうかを答えていない | 保存の前に塗り、塗れない画像は保存しないと言う |
スマホの写真も前処理で直せると言う | ぼけや写っていない欄は前処理では戻らない | 受付の時点で判定し、その場で撮り直してもらう |
止まったときの話をしない | 停止時は手入力に戻せる、という前提に答えていない | どこが止まっても画像を失わず、手入力に切り替えられると言う |
▼解説を読んだら、同じお題を AI 面接官を相手に通しで解いてみましょう。
参照元
技術ブログ、論文、公式の技術文書です。どれも開いて内容を確かめています。クラウド事業者の文書は自社製品の説明を兼ねています。
節 | 記事 | 参照した内容 |
|---|---|---|
4 | Advancing Invoice Document Processing at Uber using GenAI(Uber, 2025) | OCR と LLM と検証を重ねた構成、元の書類と値を並べる確認画面、処理時間の 70% 減 |
4 | 文書画像のデータ化における VLM 活用(Sansan, 2024) | 文字の検出と認識を重ねる構成と、画像から直接答えるモデルの比べ方 |
5 | OCR-free Document Understanding Transformer(Kim ほか, 2021) | OCR を先に通す構成の弱点(重さ、柔軟さの無さ、誤りが後ろへ伝わる) |
5 | Qwen2.5 VL(Qwen, 2025) | 請求書や帳票の構造化出力、座標の JSON 出力、公開されているモデルの大きさ |
4 | Multimodal Inputs(vLLM) | OpenAI 互換の API で画像を渡して推論する |
4 | PaddleOCR(GitHub) | 日本語に対応した文字の検出と認識、レイアウト解析、CPU で動く、Apache 2.0 |
6 | Interpret and improve model accuracy and confidence scores(Microsoft Learn) | 信頼度の意味、信頼度で人の確認に回す |
6 | 人の確認を始める条件(項目ごとの信頼度、項目の欠け、無作為の抜き取り) | |
7 | Redact sensitive data from images(Google Cloud) | 画像の中の個人情報を見つけて不透明な四角で覆う |
7 | Creating a Modern OCR Pipeline Using Computer Vision and Deep Learning(Dropbox, 2017) | スマホで撮った書類の写真の扱いにくさと、向きの判定 |
▼ほかのお題の解説
サカモトエンジニア監修
外資系企業のソフトウェアエンジニア。エンジニアのキャリアや面接について X や note で発信し、テック企業を目指すエンジニア向けの面接対策プラットフォーム InterviewCat を運営しています。

公式アカウント
CaseMatch編集部
CaseMatch編集部は、就活・転職における面接対策やキャリア選択に役立つ情報を発信する編集チームです。AI面接練習サービス「CaseMatch」の運営で得た知見や、企業選考・ケース面接・自己分析に関する実践的なノウハウをもとに、候補者が納得感を持って選考に臨めるコンテンツをお届けします。
面接練習で、選考を有利に進めよう。

1分で完了


