
ケース面接
2026/11/03
技術設計面接の解説と模範解答|映画サブスクの推薦機能
目次
技術設計面接(システムデザイン面接)のお題「映画サブスクの推薦機能」を題材に、事前に押さえておく知識、面接で引き出せる前提、論点、模範解答、よくあるつまずきを順に解説します。
ほかのお題の解説は技術設計面接の解説と模範解答まとめにあります。
より詳しい情報はこちら
この記事で使う設計の基礎は、日本語のシステムデザイン面接の教材 SystemDesign InterviewCat で詳しく学べます。この記事の各節に関係する章は次のとおりです。
InterviewCat の章 | この記事で関係する節 |
|---|---|
SystemDesign InterviewCat の全体像 | |
面接で見られることと進め方 | |
事前知識、4. 全体構成(夜間バッチ) | |
5. 観た直後の反映 | |
4. 全体構成(推薦結果ストア)、5. 表示時の処理 | |
5. 表示時の処理(配信中の作品をメモリに持つ) | |
5. 人気順への切り替え、8. 障害への備え | |
7. 良い推薦の測り方(表示ログの集計) |
事前知識:推薦をいつ計算するかと最初の仮説
設計面接では、お題を聞いた時点で「たぶんこの作りだろう」という仮説を持ち、前提を聞くたびにそれを確かめたり崩したりします。推薦機能のお題なら、まず「会員ごとのおすすめを、いつ計算するか」の選択肢を押さえておきます。夜のうちにまとめて計算して保存しておくか、トップ画面を開くたびにその場で計算するか、その組み合わせか、です。
推薦の計算とは、会員ごとに全作品へ「この人が観そうな度合い」の点を付け、点の高い順に並べることです。たとえば『ローマの休日』を最後まで観た人には、同じ作品を最後まで観た人がよく観ている作品ほど高い点が付きます。点を付ける計算式をモデルと呼びます。この節では、会員の A さんが 21 時に『ローマの休日』を観終えてトップ画面に戻る場面と、その日の 15 時に配信が終わった作品を例にして、方式を比べます。
おすすめの列が表示されるまでの流れ
A さんがトップ画面を開くと、端末は推薦 API に「この会員のおすすめ」を問い合わせます。推薦 API が答えを返すには、夜のうちに計算しておいた並びを読むか、その場で計算するかのどちらかが要ります。
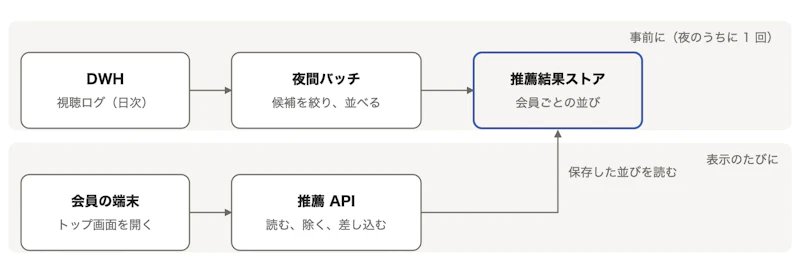
- 視聴ログ:会員が作品を再生した、止めた、どこまで観たか、の記録
- DWH:視聴ログを日ごとに集めて置く、分析用のデータベース
- 採点:モデルで 1 つの作品に点を付けること
- バッチ:夜のうちに、全会員分のおすすめをまとめて計算しておく処理
- 推薦結果ストア:計算したおすすめの並びを、会員ごとに保存しておく場所。会員を指定すればすぐ読める
それぞれの方式で何が起きるか
A さんがトップ画面を開いたとき、方式ごとに裏で起きることを並べます。
事前に計算する(バッチ):毎晩、全会員について作品を採点して並べ、上位の並びを推薦結果ストアに保存します。表示のときは会員 ID で 1 回読むだけなので速く、21 時台に大勢が開いても計算は増えません。重いモデルも夜のうちに時間をかけて回せます。弱いところは、計算した時点の情報で固定されることです。そこから 2 つのことが起きます。15 時に配信が終わった作品が A さんの並びに残り、観終えたばかりの『ローマの休日』も次に開いたときにまだおすすめに出ます。トップ画面を開かない会員の分まで計算するので、無駄も出ます。
表示のたびに計算する(オンライン):A さんがトップ画面を開くたびに、A さんの履歴を読み、作品を採点して並べます。事前に計算する方式と比べると、配信の終了や『ローマの休日』を観たことをその場で反映でき、開かない会員の分を計算する無駄もありません。その代わり、採点が終わるまで応答が返らないので、モデルが重いほど応答時間の上限に収まりにくくなります。21 時台には開いた人数の分だけ計算が増えるので、その山に合わせた計算用のサーバーを常に用意しておく必要があります。
組み合わせる:重い計算は事前に済ませ、表示のときは保存した並びを読んで、軽い処理だけをします。軽い処理とは、配信が終わった作品を除く、観た作品を外す、決まった枠に作品を差し込む、のように、モデルを使わず配信中の作品の一覧などと突き合わせるだけで済むものです。事前に計算する方式の速さを保ったまま、固定される弱みのうち急ぎのものだけを表示のときに直せます。その代わり、表示のときに参照する情報(配信中の作品の一覧など)を常に新しく保つ仕組みが別に要ります。
どの方式でも、推薦の計算が止まったときに何を出すかは別に決めておく必要があります。保存した並びが読めない、または時間内に返せないときは、全員共通の人気順のような計算の要らない答えに切り替えます。
方式を比べる
方式の違いは、「21 時台に大勢が開いたとき」「昼に配信が終わったとき」「観終えた直後」の 3 つの場面で比べると分かりやすくなります。
方式 | 21 時台に大勢が開いたとき、表示のたびの仕事は | 15 時に配信が終わった作品は | A さんが『ローマの休日』を観終えてトップへ戻ったとき |
|---|---|---|---|
事前に計算する | 保存した並びを 1 回読むだけ | 翌晩の計算まで並びに残る | 『ローマの休日』がまだ出る |
表示のたびに計算する | 開いた人数の分だけ作品を採点する | 次に開いたときから消える | 観たことを反映した並びが出る |
組み合わせる | 読み取りと、一覧と突き合わせる軽い処理だけ | 表示のときに除くので、次に開いたときから消える | 『ローマの休日』を外し、似た作品を前に出すところまでは反映できる |
表から分かるとおり、事前に計算する方式は速いが変化に遅れ、表示のたびに計算する方式は変化に追いつくが、21 時台の山に合わせて計算の用意が要ります。組み合わせる方式は両方の良いところを取れますが、表示のときに参照する情報を新しく保つ仕組みと、計算が止まったときの切り替え先が別に要ります。
候補を絞ってから並べる
夜に済ませる重い計算は、ふつう 2 つの手順に分けます。全会員と全作品の組をすべて細かく採点すると重いので、まず手早い方法で 1 人あたり数百本に絞り(候補生成)、その数百本だけを細かく採点して並べます(ランキング)。YouTube もこの 2 つの手順で、数百万本から数百本に絞ってから並べています。
候補生成の方法には大きく 2 つあり、このお題では新作の扱いで違いが出ます。
- 協調フィルタリング:A さんと似た作品を観ている人が観た作品を出す。視聴の記録が無い新作には使えない
- 内容ベース:『ローマの休日』と同じジャンルや監督の作品を出す。作品の情報だけで出せるので、新作にも使える
最初の仮説
お題文だけを読んだ段階では、次の仮説を置きがちです。どれも筋は悪くありませんが、前提を聞くと一部が崩れます。答え合わせは「隠れていた前提を見直す」で行います。
仮説 | 中身 | 確かめること |
|---|---|---|
1 | 毎晩全会員分を計算して保存し、表示のときはそれを返すだけでよい | 応答時間、配信が終わる時刻、観た直後の扱い、表示を約束した作品があるか |
2 | 視聴履歴から協調フィルタリングで推薦すればよい | 新作の数、評価の有無、1 つの会員を何人で使うか |
3 | おすすめのクリック率で良し悪しを測ればよい | このサービスが最終的に何を良くしたいか、効果が出るまでの期間 |
4 | 精度の高い深層学習のモデルを使えばよい | GPU、費用、作れる人の数、作品数の伸び |
お題と要件
面接官から示されるお題は次のとおりです。
本日はシステムの設計方法についてディスカッションしたいと思います。今、動画配信サービスで映画をもっと観てもらうために、おすすめ作品の推薦機能を作ることを考えています。トップ画面に、会員ごとのおすすめ作品の列を表示したいです
▼このお題は CaseMatch の AI 面接で、面接官に前提を質問しながら練習できます。
前提は質問すれば答えてもらえます。面接で引き出せる前提を、推薦をいつ計算するかの選び方に関わるものとそれ以外に分けて並べます。種類の列は、機能要件、非機能要件、制約、将来の計画のどれにあたるかです。値は面接官の答えそのままです。設計への影響の列は、次の節の問いを考えてから読んでください。
推薦をいつ計算するかに関わる前提
事前知識の比較表の 3 つの場面(利用の集中、配信の終了、観た直後)と、応答時間、計算が止まったときの扱い、計算にかけられる費用を決める前提です。
種類 | 前提 | 値 | 設計への影響 |
|---|---|---|---|
非機能 | 規模 | 会員150万人、作品1万本 | 表示のたびに全作品を採点すると、ピークの計算量が大きい |
非機能 | ピーク | 21時台に同時50万人 | 表示のときの仕事を、保存した並びの読み取りと軽い処理に限る |
非機能 | 応答時間 | 推薦200ms以内 | 重いモデルは表示のときに回さない |
非機能 | 履歴の反映 | 履歴反映は翌日まででよい | 本体の計算は日次のバッチでよい |
機能 | 表示する数 | トップの列には20作品を表示する | 除外で減るぶん、保存する並びは 20 より多く持つ |
機能 | 観た直後 | 観た直後におすすめを変えたい | 翌日反映とぶつかる。直後の分だけ別に流す |
制約 | 期限切れ | 期限切れ作品はすぐ表示から消す | 夜の計算結果に任せず、表示のときに除く |
制約 | 配信期限 | 配信期限は権利で決まり、毎日0時のほか不定期にも終わる | 配信中の作品の一覧を随時更新する |
制約 | 障害時 | 障害時は人気順にする | 人気順を事前に用意し、時間切れでも切り替える |
制約 | ログの置き場 | 視聴ログは日次でDWHに入る | 夜間バッチの入力はそのまま使える。直後の視聴は別の経路が要る |
制約 | GPU | 社内にGPUは無く、使うなら調達が要る | CPU で回る手法から始める |
制約 | 費用 | 推薦の計算と配信にかかる費用は月200万円以内 | 常時動くサーバーより、夜だけ動くバッチに寄せる |
将来 | 作品数 | 作品数を2年で10倍にする計画がある | 全組を採点する計算は伸ばせないので、候補を絞ってから並べる |
それ以外の前提
目標、データの中身、表示のルール、体制のように、どの方式を選んでも別に設計が要る前提です。
種類 | 前提 | 値 | 設計への影響 |
|---|---|---|---|
機能 | 目標 | おすすめから再生される作品を増やし、解約率を月3%から2.5%に下げたい | クリックだけでなく解約率まで測る |
機能 | 効果の判断 | 効果はA/Bテストで、1か月の視聴時間と解約率を見て判断する | テストは 1 か月より短くできない |
機能 | 作る範囲 | 検索や作品詳細ページの関連作品は対象外で、トップの1列だけを作る | 作るのは 1 列の API だけ |
機能 | 新作 | 新作は月約100本追加される | 視聴の記録がない作品を出す方法が要る |
機能 | R指定 | R指定の作品は、子ども向けを多く観ている会員のおすすめに出さない | 会員ごとの判定を持ち、表示のときにも除く |
機能 | 配給契約 | 特定作品を一定回数表示する配給契約がある | 好みの順位とは別に差し込む枠が要る |
機能 | 契約の確認 | 配給契約の表示回数は月単位で、達成状況を営業が週次で確認する | 表示した作品をログに残して数える |
非機能 | 会員の出入り | 新規会員は月約3万人、解約率は月約3% | 履歴のない会員を毎日迎える |
制約 | 視聴ログの中身 | 視聴ログは1日約800万イベント(再生・一時停止・停止・到達位置) | どこまで観たかを好みの手がかりにできる |
制約 | 評価 | 評価会員は1割未満、視聴到達位置は全員分ある | 星の評価ではなく視聴の記録で学ぶ |
制約 | 作品の情報 | 作品の情報はジャンル・出演者・監督・公開年・あらすじが揃っている | 新作は内容ベースで出せる |
制約 | 家族共有 | 家族共有が多いがプロフィール機能はない | 1 つの履歴に複数人の好みが混ざる |
制約 | 端末 | 端末はテレビ6割・スマホ3割・PC1割、テレビアプリは更新が数か月遅れる | 推薦の中身はサーバー側だけで変えられるようにする |
制約 | 今のトップ | 今のトップ画面は、全員に同じ人気ランキングを出している | 比べる相手と、障害時の切り替え先がすでにある |
制約 | A/B の仕組み | 会員単位で割り当てるA/Bテストの仕組みがある | 割り当ては作らず、表示ログに群を残す |
制約 | 体制 | ML担当は2名、データ基盤は別チーム | 運用の手間が少ない作りにする |
制約 | 期間 | 4か月後にA/Bテストを始め、効果が出たら全会員に広げる | 最初は簡単なモデルで測れる形を先に作る |
隠れていた前提を見直す
お題文は「会員ごとのおすすめ作品の列を表示したい」としか言っていません。前提の表は、質問して初めて出てきたものです。設計への影響を見る前に、あらためて前提を読み直し、お題文の裏に何が隠れていたかを考えます。先に次の問いを考えてから、前提の表の「設計への影響」の列と見比べてください。
- 前提のうち、互いにぶつかっている 2 つの組を 3 組挙げてください。
- 推薦を事前に計算したい理由と、表示のときに処理したい理由を、前提から 1 つずつ挙げてください。
- 最初の仮説 1〜4 のうち、どれがどの前提で崩れますか。
- お題文からは読み取れなかったのに、設計を一番大きく変えた前提はどれですか。
前提どうしのぶつかり
前提の多くは単独では難しくありません。難しいのは 2 つが互いに逆を向いているところで、このお題では次の 3 組です。これがそのまま、面接の後半で詳しく問われる 3 つの論点(深掘り)になります。
ぶつかる前提 | なぜぶつかるか | 解き方 |
|---|---|---|
推薦 200ms、21 時台に同時 50 万人 × 期限切れはすぐ消す、観た直後に変えたい | 速さのためには事前に計算したいが、事前の結果は計算した時点で固定される | 重い計算は夜に済ませ、配信の終了と観た作品の除外、契約作品の差し込みだけを表示のときに行う |
おすすめから再生される作品を増やす × 新作は月約 100 本追加される | 観た記録に寄せて並べるほど、記録のない新作は列に出ない | 20 作品のうち数枠を新作と普段観ないジャンルに使い、その反応を翌晩の計算の入力に使う |
解約率を月 3% から 2.5% に下げたい × 4 か月後に A/B テストを始める(効果は 1 か月の視聴時間と解約率で判断) | すぐ測れるクリックは目標から遠く、解約率は始めてから 1 か月以上たたないと判断できない | すぐ動く指標と判断に使う指標を分け、日々はおすすめからの再生と視聴到達位置を見て、判断は解約率で行う |
仮説の答え合わせ
仮説 | 崩した前提 | 置き換え |
|---|---|---|
1. 毎晩計算して返すだけ | 期限切れはすぐ消す、配信は不定期にも終わる、観た直後に変えたい、配給契約 | 「重い計算は毎晩」は正しい。崩れるのは「返すだけ」で、表示のときに配信の終了と観た作品を除き、契約と新作の枠を差し込む |
2. 協調フィルタリングで十分 | 新作は月約 100 本、評価会員は 1 割未満、家族共有 | 評価ではなく視聴到達位置で学ぶ。新作は作品の情報を使う内容ベースで出し始め、家族で混ざった好みには列に複数の好みの作品を並べて応える |
3. クリック率で測る | 解約率を下げたい、1 か月の視聴時間と解約率で判断する | クリックは日々の確認にとどめ、判断は視聴時間と解約率で行う。テストは 1 か月以上回す |
4. 深層学習のモデル | GPU が無い、ML 担当 2 名、4 か月後に開始、月 200 万円 | CPU で回る行列分解などの手法で始め、測れる形を先に作る。モデルは A/B で入れ替えればよい |
このお題は推薦アルゴリズムの選び方を問うように見えます。しかし実際に問われるのは、毎晩の計算と表示のときの処理をどう分けて 200ms を守るか、好みと探索をどう混ぜるか、その効果を解約率という遅い指標でどう判断するかです。
解説:このお題の論点
論点は 3 つあり、重さの順に事前計算と表示時の処理の分担、精度と多様性の両立、良い推薦の測り方です。推薦アルゴリズムの名前や細かい手法は深く問われません。
模範解答の深掘り(5〜7)では、論点ごとに「弱い答え」「よい答え」「より良い答え」を並べ、何が足りないかを示しています。
模範解答
面接での問答の順には合わせず、このお題への答えを 1 つの設計としてまとめた解答例です。設計の筋は、重い推薦の計算は毎晩のバッチで済ませて会員ごとに保存し、表示のときは保存した並びを読んで配信中の作品の一覧などと突き合わせる軽い処理だけをし、間に合わないときは人気順に切り替える、というものです。前提に無いことは仮定として置き、その旨を書いています。
1. 作る範囲
前提を確かめたうえで、最初に作る範囲を次のように切ります。
- 作る:毎晩の推薦の計算、推薦結果の保存と配信、表示のときの除外と差し込み、観た直後の反映、人気順への切り替え、表示ログ、A/B テストの集計
- 作らない:検索、作品詳細ページの関連作品、トップのほかの列、プロフィール機能、テレビアプリの画面の作り直し
テレビアプリは更新が数か月遅れるので、アプリは今の人気ランキングの列と同じ形で 20 作品を受け取って並べるだけにし、何をどの順で出すかはすべてサーバー側で決めます。
2. 見積もり
見積もりで出すのは、構成を決める 3 つの数字だけです。どれも前提の値から計算できます。
見積もり | 計算 | 決まること |
|---|---|---|
1 回の表示の仕事 | 表示 1 回 × 作品 1 万本 = 1 万回の採点(保存した並びなら読み取り 1 回) | 表示のときはモデルを回さず、保存した並びを読む |
毎晩の計算 | 会員 150 万人 × 作品 1 万本 = 150 億組 | 候補を数百本に絞ってから並べる |
表示する数 | トップの列の 20 作品 + 表示のときに除く作品の分 | 保存する並びは 20 本より多く持つ |
3. データモデル
推薦結果は毎晩まるごと作り直す使い捨ての表とし、表示のときに変わり得る情報(配信中かどうか、契約の残り回数)は別の表に持って、表示のときに突き合わせます。中心になる表は次の 4 つです。
表 | 主な項目 | 書き換え |
|---|---|---|
推薦結果 | 会員 ID、作品 ID の並び(20 本より多め)、R 指定を除くかの判定、計算日、モデルの版 | 毎晩、新しい並びを全部書き終えてから、推薦 API が読む先を新しい並びに替える |
作品 | 作品 ID、配信期限、配信中かどうか、R 指定かどうか、ジャンル、追加日 | 配信の終了や新作の追加のたびに更新する |
配給契約 | 作品 ID、月の目標表示回数、今月の表示回数 | 表示ログから数え直して更新する |
表示ログ | 会員 ID、表示した 20 作品と位置、枠の種類(好み、探索、新作、契約、人気順)、A/B の群、日時 | 追記のみ |
並びを 20 本より多めに持つのは、表示のときに配信の終了、観た作品、R 指定を除いても 20 本が残るようにするためです。何本持つかは、表示のときに除かれる本数を見て決めます。
4. 全体構成
会員がトップ画面を開いたときに通るのは推薦 API と、そこから読むストアだけです。推薦の計算は夜のバッチで、配信の終了と観た直後の変化は随時の小さな更新で、それぞれ表示とは別に動きます。
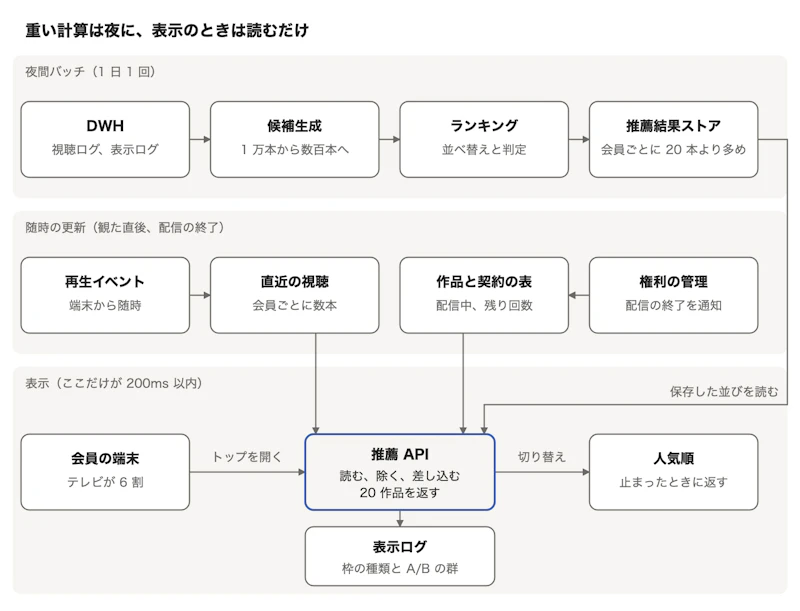
色を付けた推薦 API がこの設計の要で、表示のときの処理はここに集め、モデルは呼びません。
- 候補生成とランキング(夜間バッチ):DWH の視聴ログから、視聴到達位置を好みの強さとして使い、協調フィルタリングで候補を数百本出します。新作と視聴の少ない作品は、作品の情報を使う内容ベースで候補に足します。ランキングでは同じジャンルが続かないように並べ替え、会員ごとに 20 本より多めの並びと、子ども向けを多く観ているかの判定を作ります。全員分の人気順もここで作ります。
- 推薦結果ストア:会員 ID を指定すると並びを返す、読み取りの速いキーバリューストアです。毎晩の結果は新しい並びとして全部書き終えてから、推薦 API が読む先を新しい並びに替えるので、書いている途中の中途半端な並びは出ません。
- 作品と契約の表:配信中の作品の一覧、R 指定の作品、配給契約の残り回数です。権利の管理から配信の終了を受けて随時更新し、推薦 API は手元のメモリに写して使います。
- 直近の視聴:端末からの再生イベントを受け、会員ごとに直近に観た数本だけを保存します。翌日の DWH を待たずに、観た直後の表示に使います。
- 推薦 API:保存した並びを読み、配信が終わった作品、観た作品、R 指定(判定が付いた会員のみ)を除き、探索、新作、契約の枠を差し込んで 20 作品を返します。決めた時間内に読めなければ人気順を返します。
- 表示ログ:返した 20 作品、位置、枠の種類、A/B の群を残します。契約の表示回数の集計、探索の反応の学習、A/B テストの判断はすべてこのログから行います。
夜間バッチは CPU のマネージドな基盤で夜だけ動かし、常に動くのは推薦 API とストアだけにして、月 200 万円の中に収めます。データ基盤は別チームなので、DWH からの読み出しと表示ログの取り込みは、そのチームが用意している既存の取り込みの仕組みを使います(仮定)。
実例:YouTube の推薦は、候補生成で数百本に絞り、別のモデルで並べる 2 つの手順でできています。候補生成には、数十ミリ秒の応答時間の中で数百万本を採点するために、近似の近傍検索を使っています(Covington ほか, 2016)。Google の推薦システムの教材も、候補生成、採点、並べ替え直しの 3 つの手順に分け、最後の並べ替え直しで鮮度や多様性を整えると説明しています(Google for Developers)。
代わりの案:推薦の計算そのものを Amazon Personalize のようなマネージドな推薦サービスに任せる構成も有力です。まとめて全会員分を出すバッチの推薦(AWS, バッチの推薦)と、問い合わせのたびに返すリアルタイムの推薦の両方があります。リアルタイムの推薦では、条件に合わない作品をフィルタで除くと、その代わりに条件に合う次の作品が入ります(AWS, リアルタイムの推薦のフィルタ)。指定した割合の作品を別の条件で選んで差し込むプロモーションもあります(AWS, プロモーション)。ML 担当 2 名で 4 か月という前提に合います。その場合も、配信の終了の除外と人気順への切り替えは自前の推薦 API に残します。外部のサービスが止まったときにも 200ms 以内で人気順を返す必要があるからです。
5. 深掘り:事前計算と表示時の処理の分担
推薦の並びは毎晩計算して保存し、表示のときはそれを読んで、配信中の作品の一覧などと突き合わせるだけで済む処理(除外と差し込み)だけを行います。最初の仮説の 1 は、ここで崩れます。毎晩計算する点は残し、「返すだけ」を「読んで直してから返す」に替えます。表示のたびに計算する方式を選ばないのは、履歴の反映は翌日まででよく、表示のたびに計算しても得るものが少ないからです。そのうえ 21 時台の山に合わせた計算用のサーバーを常に用意することになり、月 200 万円、GPU なし、ML 担当 2 名という前提と合いません。
答えの段階 | 答え | 足りないところ |
|---|---|---|
弱い答え | トップを開くたびにモデルで推薦を計算します | 21 時台は開いた人数の分だけ計算が増え、常に動かすサーバーの費用と運用が前提に合わず、重いモデルほど 200ms が苦しくなる |
よい答え | 毎晩全会員分を計算して保存し、表示のときはそれを返します | 夜の計算のあとに配信が終わった作品や、今観た作品がそのまま出る。推薦が止まったときの答えがない |
より良い答え | 毎晩計算して保存し、表示のときに除外と差し込みを行い、間に合わなければ人気順を返します | なし(中身は下の 5 つ) |
より良い答えの中身は次のとおりです。
- 配信の終了は表示のときに除く:配信期限は毎日 0 時のほか不定期にも終わるので、夜の計算結果からは消せません。権利の管理から終了を受けて作品の表を更新し、推薦 API はメモリに写した配信中の一覧で毎回除きます。1 万本の一覧なので、各サーバーのメモリに十分載ります。
- 観た直後は、観た作品を外し、似た作品を前に出す:再生イベントから直近に観た数本を保存し、表示のときにその作品を外し、夜に計算しておいた「この作品に似た作品」を数本前に出します。好みの学び直しそのものは翌晩のバッチに任せるので、前提の「履歴反映は翌日まで」と「観た直後に変えたい」の両方を満たせます。
- 契約の作品は枠で差し込む:配給契約の作品は好みの順位とは別に、20 作品のうち決めた数の枠に差し込みます。今月の目標に対して表示が遅れている作品ほど差し込む割合を上げ、その会員の好みに近い位置に置きます。表示回数は表示ログから毎日数え直し、営業が週次で見る集計もここから作ります。
- R 指定は夜の計算と表示のときの 2 か所で除く:子ども向けを多く観ている会員の判定は夜に計算して並びと一緒に保存し、ランキングで除いたうえで、表示のときにも R 指定の作品を除きます。夜の計算のあとに追加された作品が漏れないようにするためです。
- 時間を決めて人気順へ切り替える:200ms のうち、推薦結果ストアの読み取りに使える時間を決めておき、超えたら待たずに人気順を返します。ストアへの失敗が続いたら一定時間は問い合わせ自体を止め(サーキットブレーカー)、止まっているストアに問い合わせが集中しないようにします。人気順も配信中の一覧で除外してから返します。
この構成で最初に詰まるのは推薦 API ではなく、夜間バッチの終わる時刻です。作品が 10 倍になると候補生成の計算が増え、朝までに終わらない日が出ます。その日は前日の並びを使い続け、表示のときの除外で配信の終了には追いつけるので、読者に見えるのは並びが 1 日古いことだけです。
実例:Amazon Personalize は、全会員分をまとめて出すバッチの推薦と、問い合わせのたびに返すリアルタイムの推薦を分けて提供しています。バッチはジョブ開始の 15 分前までのデータしか使わないので、リアルタイムの推薦と完全には一致しないと明記しています(AWS, バッチの推薦)。Eugene Yan は、学習や索引作りを行うオフラインの環境と、その成果物を使って 1 件ずつの問い合わせに答えるオンラインの環境に分ける構成を、多くの企業の例とともに整理しています(Eugene Yan, 2021)。
6. 深掘り:精度と多様性の両立
20 作品のうち大半は好みに近い順で埋め、残りの数枠を探索と新作に使い、その反応を表示ログから翌晩の計算の入力に使います。
答えの段階 | 答え | 足りないところ |
|---|---|---|
弱い答え | 好みに近い順に 20 作品を並べます | 似た作品ばかりになり、新作は記録がないので出ない |
よい答え | 普段観ないジャンルや新作も混ぜます | どれだけ、どう混ぜるかと、混ぜた結果をどう使うかがない |
より良い答え | 枠を決めて混ぜ、ジャンルが続かないように並べ、反応を翌晩の計算の入力に使います | なし(中身は下の 4 つ) |
- 枠を決めて混ぜる:20 作品のうち数枠を探索(普段観ないジャンルで評判のよい作品)と新作に使います。枠の数は A/B テストで決めます。
- 新作は内容ベースで出し始める:新作は月約 100 本あり、追加した日には視聴の記録がありません。ジャンル、出演者、監督が近い作品をよく観た会員に新作枠で出し、数日分の視聴がたまったら協調フィルタリングの候補にも入るようにします。
- ジャンルが続かないように並べる:ランキングの最後に、同じジャンルが続いたら次点の作品と入れ替えます。家族共有ではプロフィール機能がないので 1 つの履歴に大人と子どもの好みが入っています。列の中に複数の好みの作品が並んでいれば、そのとき観ている人が自分向けの作品を見つけやすくなります。
- 反応を翌晩の計算の入力に使う:表示ログに枠の種類を残しておけば、探索や新作の枠から再生された作品と、表示されたのに選ばれなかった作品を区別して学習に使えます。探索の枠で反応のあったジャンルは、翌晩からその会員の好みの候補に入ります。
探索の枠を増やすと、短い期間ではおすすめからの再生が減ることがあります。好みに近い作品の枠を探索に譲るからです。探索の効果は長く使い続けてもらえるかに出るので、枠の数は 7 の長めの A/B テストで決めます。
実例:Netflix は、多くのアカウントが家族で共有されており、プロフィールを作れるようにしたあとも 1 つのプロフィールを複数人で使う例が多いため、誰が観ていても見つけられるように推薦を混ぜていると書いています。好みだけで並べるより、人気の度合いを適度に混ぜたほうがうまくいくとも述べています(Gomez-Uribe, Hunt, 2015)。Spotify は、聴く曲の幅が広い利用者ほど有料への転換や継続が多い一方で、推薦から聴く曲は幅が狭くなりやすいと報告しています(Anderson ほか, 2020)。
7. 深掘り:良い推薦の測り方
すぐ動く指標と判断に使う指標を分け、日々はおすすめからの再生と視聴到達位置を確認し、効果の判断は前提どおり 1 か月の視聴時間と解約率で行います。
答えの段階 | 答え | 足りないところ |
|---|---|---|
弱い答え | 推薦の精度を測ります | 何を、何のために測るかがない |
よい答え | クリック率と視聴完了率を A/B テストで比べます | 目標の解約率まで届いているか分からない。テストの期間がない |
より良い答え | すぐ動く指標と判断に使う指標を分け、解約率で判断できるだけの期間 A/B テストを回します | なし(中身は下の 4 つ) |
- すぐ動く指標と判断に使う指標を分ける:すぐ動く指標は、おすすめの列から再生された割合と、どこまで観たか(視聴到達位置)です。判断に使うのは、前提どおり 1 か月の視聴時間と解約率です。クリックだけを追うと、題名や画像で選ばれて途中でやめられる作品が上に来るので、どこまで観たかと組にして見ます。
- テストの期間を長めに取る:解約は月単位でしか起きないので、テストは少なくとも 1 か月回します。会員は 150 万人いるので群の人数は足ります。判断を遅らせるのは期間のほうです。
- 新規会員を分けて見る:新規会員は月約 3 万人で、履歴がないので推薦の当たり方が既存会員と違います。群の中で新規会員と既存会員を分けて集計し、片方だけ悪くなっていないかを確かめます。
- 過去のログでの事前評価は足切りに使う:A/B の前に、過去の視聴ログで翌日の視聴をどれだけ当てられるかを比べ、明らかに悪いモデルを外します。過去のログでの結果と A/B の結果は一致しないことがあるので、判断は A/B で行います。
A/B の群は既存の会員単位の仕組みで割り当てます。家族で共有している会員は、群が会員単位なので家族全員が同じ群に入り、家族の中で見える列が群ごとに分かれることはありません。表示ログに群を残し、DWH で群ごとに集計します。
実例:Netflix は、売上が会員数に比例する定額制なので、推薦の良し悪しを中期の視聴の量と解約率で判断しています。A/B テストは会員を群に分けて通常 2〜6 か月回し、推薦の改善で月の解約率を数ポイント下げたと書いています(Gomez-Uribe, Hunt, 2015)。YouTube は、クリック率で並べると最後まで観られない釣りの動画が上に来るので、表示 1 回あたりの期待視聴時間で並べています。過去のデータでの評価は A/B の結果と相関しないことがあるので、最終判断は A/B で行うとも書いています(Covington ほか, 2016)。Google 検索の広告では、A/B テストの短期の効果が長期の効果を予測しないことがあり、長期の変化を測る方法を作っています(Hohnhold ほか, 2015)。
8. 障害への備えと監視
どこが止まっても、トップには何かしらの 20 作品が出続けます。配信が終わった作品だけは、止まったときにも出さないほうを選びます。
止まるもの | 会員に見えること | 手当て |
|---|---|---|
推薦結果ストア | 人気順の列が出る | 読み取りの時間を決めて人気順に切り替え、失敗が続いたら問い合わせを一時止める |
夜間バッチ | 前日の並びが出る | 新しい並びを全部書き終えるまで読む先を替えないので、途中の結果は出ない。並びが決めた日数より古くなったら人気順にする |
配信の終了の通知 | 終わった作品が出るおそれ | 期限の時刻が決まっている作品は、通知が届かなくても時刻で除く。不定期の終了の通知が遅れていないかを監視する |
再生イベントを受け取る処理 | 観た作品がしばらく出る | 翌日の DWH で反映される。推薦の計算には影響しない |
表示ログの取り込み | 変わらない | 契約の表示回数の集計が遅れる。ログは端末やサーバー側で再送し、ログの ID で二重に数えないようにする |
監視するのは、推薦 API の応答時間(遅いほうの 1% を含む)、人気順に切り替えた割合、推薦結果の計算日の古さ、配信が終わった作品を返した件数(0 であるべき)、契約作品の表示回数の進み具合です。
9. 条件の変更への対応
面接の後半では、運用で起きた不具合や将来の計画という形で条件が足されます。答え方は、今の設計でなぜ起きたか、何をきっかけに何をどう処理して直すか、変えずに済むところはどこか、の順です。
例 1:配信が終わった作品が、夜までおすすめに出ていた
- 原因:昼に不定期で配信が終わった作品を、夜間バッチの結果からしか除いていなかった。もしくは推薦 API がメモリに写した配信中の一覧を、起動したときにしか読み込んでいなかった。
- 直し方:権利の管理から終了の通知を受けて作品の表を更新し、推薦 API は一覧を短い間隔で読み直します。通知は同じものが 2 回届いても結果が変わらないように、作品 ID と終了時刻で上書きする形で反映します。返した 20 作品に配信が終わった作品が含まれていないかを表示ログで毎日突き合わせ、1 件でもあれば通知します。
- 変えずに済むところ:夜間バッチ、推薦結果ストア、指標とテストの仕組みです。
例 2:作品数を 2 年で 10 倍にする
- 影響:全作品を候補にする計算が 10 倍になり、夜間バッチが朝までに終わらなくなります。配信中の一覧も 10 万本になります。
- 直し方:候補生成を、作品と会員を同じ空間のベクトルにして近いものを近似の近傍検索で取る方式にし、計算を作品数に比例させないようにします。ランキングは候補の数百本だけを並べるので、作品が増えても計算はほとんど増えません。配信中の一覧は 10 万本でもメモリに載ります。
- 変えずに済むところ:推薦 API の処理、表示ログ、指標とテストの仕組みです。表示のときの仕事は作品数に関係なく、保存した並びの読み取りと除外だけだからです。
まとめ:選んだものと捨てたもの
判断 | 選んだ案 | 捨てた案、代わりの案 | 理由 |
|---|---|---|---|
計算の時期 | 毎晩計算して保存し、表示のときは読むだけ | 表示のたびにモデルで計算 | 履歴は翌日反映でよく、21 時台の山に合わせた計算用のサーバーを常に持たずに月 200 万円に収まる |
表示のときの処理 | 配信の終了、観た作品、R 指定を除き、探索、新作、契約の枠を差し込む | 夜の結果をそのまま返す | 期限切れはすぐ消す、観た直後に変える、契約の回数を守る |
障害時 | 時間を決めて人気順に切り替える | 推薦を待ち続ける、エラーを返す | 前提どおり人気順にし、200ms を守る |
推薦の手法 | 視聴到達位置で学ぶ協調フィルタリングと、新作の内容ベース | 深層学習のモデル。代わりの案:マネージドな推薦サービス | GPU が無く、ML 担当 2 名で 4 か月後に測れる形を先に作る |
多様性 | 枠を決めて探索と新作を混ぜ、ジャンルが続かないように並べる | 好みに近い順だけ | 似た作品ばかりを避け、家族共有の混ざった好みにも応える |
測り方 | 再生と視聴到達位置で日々確認し、1 か月以上の A/B で視聴時間と解約率を見て判断 | クリック率だけ | 目標は解約率で、クリックは途中でやめる作品を上げてしまう |
よくあるつまずき
つまずき | なぜ弱いか | 抜け出す一手 |
|---|---|---|
最初からアルゴリズムの名前を並べる | 応答時間や配信の終了など、構成を決める条件を取りこぼす | 応答時間、ピーク、反映の速さ、止まったときの扱いを先に聞く |
表示のたびにモデルで計算する | 21 時台の山に合わせた計算用のサーバーが常に要り、月 200 万円、GPU なし、ML 担当 2 名と合わない | 履歴は翌日まででよいので、重い計算は夜に回すと言う |
毎晩計算した結果を返すだけにする | 昼に配信が終わった作品や、今観た作品が出る | 表示のときに配信中の作品の一覧と突き合わせて除く処理を足す |
障害時は人気順、とだけ言う | 遅いだけで止まっていないときに 200ms を超える | 読み取りの時間を決め、超えたら切り替えると言う |
多様性も大事、とだけ言う | どれだけ、どう混ぜ、結果をどう使うかがない | 枠の数、並べ方、反応の返し方を言う |
新作も協調フィルタリングで出す | 追加した日の新作には視聴の記録がない | 作品の情報を使う内容ベースで出し始める |
クリック率で良し悪しを判断する | 目標の解約率まで届いているか分からない | すぐ動く指標と判断に使う指標を分け、解約率で判断できる期間テストを回す |
テレビアプリにも推薦の処理を入れる | テレビアプリは更新が数か月遅れ、直すのに時間がかかる | アプリは受け取った 20 作品を並べるだけにする |
▼解説を読んだら、同じお題を AI 面接官を相手に通しで解いてみましょう。
参照元
技術論文、技術ブログ、公式ドキュメントです。どれも開いて内容を確かめています。AWS のドキュメントは自社製品の説明を兼ねています。Netflix の論文は、公開されている PDF の写しで確かめました(原典は ACM Transactions on Management Information Systems, 2015)。
節 | 記事 | 参照した内容 |
|---|---|---|
事前知識、4, 7 | Deep Neural Networks for YouTube Recommendations(Covington ほか, RecSys 2016) | 候補生成とランキングの 2 つの手順、数十ミリ秒の応答時間、期待視聴時間で並べる理由、A/B で判断すること |
4 | Recommendation systems overview(Google for Developers) | 候補生成、採点、並べ替え直しの 3 つの手順 |
6 | Re-ranking(Google for Developers) | 並べ替え直しで鮮度と多様性を整える |
5 | System Design for Recommendations and Search(Eugene Yan, 2021) | オフラインとオンラインの環境の分け方 |
4, 5 | バッチの推薦はジョブ開始の 15 分前までのデータを使い、リアルタイムの推薦と一致しないことがある | |
4 | フィルタで除いた作品の代わりに、条件に合う次の作品が入る | |
4 | 指定した割合の作品を別の条件で選んで差し込む | |
6, 7 | The Netflix Recommender System: Algorithms, Business Value, and Innovation(Gomez-Uribe, Hunt, 2015) | 家族共有と推薦の混ぜ方、人気の混ぜ方、解約率と視聴で測る A/B テストと 2〜6 か月の期間 |
6 | Algorithmic Effects on the Diversity of Consumption on Spotify(Anderson ほか, The Web Conference 2020) | 聴く幅の広さと継続の関係、推薦で幅が狭まりやすいこと |
7 | Focus on the Long-Term: It's better for Users and Business(Hohnhold ほか, KDD 2015) | A/B テストの短期の効果が長期を予測しないこと |
▼ほかのお題の解説
サカモトエンジニア監修
外資系企業のソフトウェアエンジニア。エンジニアのキャリアや面接について X や note で発信し、テック企業を目指すエンジニア向けの面接対策プラットフォーム InterviewCat を運営しています。

公式アカウント
CaseMatch編集部
CaseMatch編集部は、就活・転職における面接対策やキャリア選択に役立つ情報を発信する編集チームです。AI面接練習サービス「CaseMatch」の運営で得た知見や、企業選考・ケース面接・自己分析に関する実践的なノウハウをもとに、候補者が納得感を持って選考に臨めるコンテンツをお届けします。
面接練習で、選考を有利に進めよう。

1分で完了


